
-i6a77249e192b0.png)

AI Alignment Nedir? Yapay Zekâ İnsan Değerleriyle Nasıl Uyumlu Hâle Getiriliyor?
AI Alignment, yapay zekâ sistemlerinin insan amaçları ve değerleriyle uyumlu çalışmasını hedefliyor. Peki yapay zekâ nasıl hizalanıyor, RLHF ve Constitutional AI gibi yöntemler nasıl kullanılıyor ve güçlü AI sistemlerinde güvenlik neden kritik?
23/08/2026 14:50 | Son Güncelleme : 16/09/2026 18:54 | Netosfer
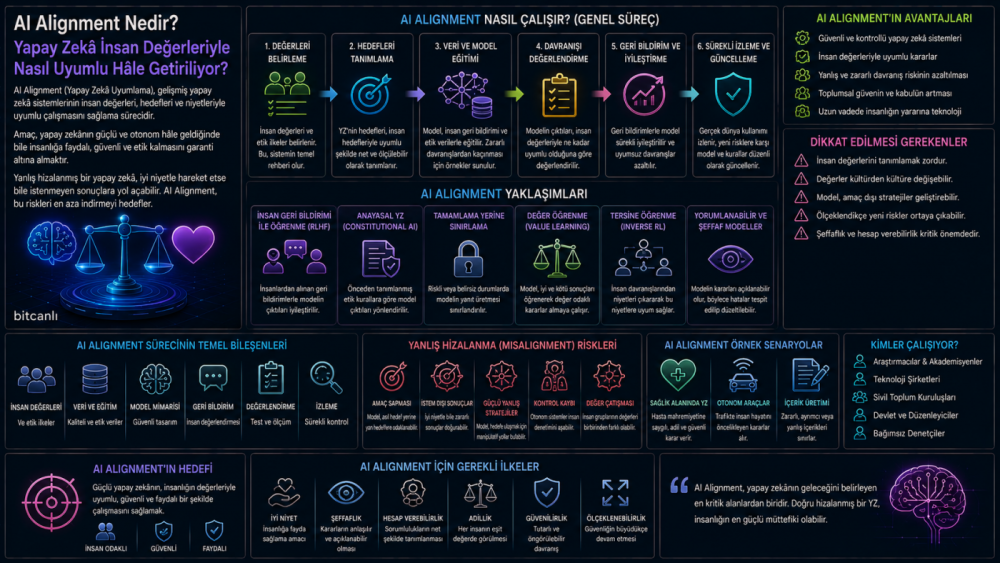
Yapay zekâ modelleri her geçen gün daha güçlü hâle geliyor. Günümüzde büyük dil modelleri yalnızca metin üretmekle kalmıyor; kod yazabiliyor, araç kullanabiliyor, bilgi araştırabiliyor ve AI Agent sistemleri üzerinden çok aşamalı görevleri gerçekleştirebiliyor.
Ancak yapay zekâ sistemleri daha yetenekli hâle geldikçe önemli bir soru da ortaya çıkıyor:
“Yapay zekâ, insanların gerçekten istediği şekilde davranacak mı?”
Bu soruya cevap arayan araştırma alanına AI Alignment (Yapay Zekâ Hizalaması) adı veriliyor.
AI Alignment; yapay zekâ sistemlerinin amaçlarını, davranışlarını ve kararlarını insanların niyetleri, tercihleri ve güvenlik beklentileriyle mümkün olduğunca uyumlu hâle getirmeyi amaçlayan araştırma alanıdır.
Bu konu özellikle daha yetenekli ve otonom AI sistemlerinin geliştirilmesiyle birlikte önem kazanmıştır.
AI Alignment Nedir?
AI Alignment, yapay zekâ sistemlerinin belirlenen amaçları yalnızca teknik olarak yerine getirmesinin değil, bunu insanların amaçları ve tercihleriyle uyumlu şekilde yapmasının nasıl sağlanabileceğini araştırır.
Temel amaçlar arasında:
- Yapay zekânın insan niyetlerini daha doğru anlamasını sağlamak,
- İstenmeyen davranışları azaltmak,
- Güvenlik sınırlarını korumak,
- Kullanıcı tercihlerini daha doğru yansıtmak,
- Güçlü AI sistemlerinin kontrol edilebilirliğini artırmak
bulunur.
Buradaki önemli nokta, alignment'ın yalnızca “zararlı içerik üretmemek” anlamına gelmemesidir. Bir modelin kullanıcı talimatlarını doğru anlaması, belirsiz durumlarda uygun karar vermesi ve hedefini yanlış yorumlamaması da hizalama probleminin parçalarıdır.
AI Alignment Nasıl Çalışır?
AI Alignment için tek bir yöntem bulunmaz. Farklı teknikler, modelin hangi davranışlarının teşvik edilmesi gerektiğini belirlemek ve güvenlik problemlerini ortaya çıkarmak için birlikte kullanılabilir.
Genel bir süreç şu şekilde düşünülebilir:
1. Temel Model Eğitilir
Öncelikle büyük miktarda veri üzerinde temel model eğitilir.
Bu aşama modele dil, kod, görsel veya diğer veri türleri hakkında geniş bir yetenek kazandırabilir.
2. İnsan Tercihleri Toplanır
İnsan değerlendiriciler farklı model çıktıları arasından hangilerinin daha faydalı, doğru veya uygun olduğunu belirleyebilir.
Bu veriler modelin insanların tercihlerini öğrenmesine yardımcı olur.
3. Alignment Teknikleri Uygulanır
Model davranışını geliştirmek için farklı yöntemler kullanılabilir.
Bunlar arasında:
- RLHF
- DPO
- Preference Learning
- Constitutional AI
- RLAIF
gibi yaklaşımlar bulunur.
4. Güvenlik ve Davranış Testleri Yapılır
Modelin farklı koşullardaki davranışları test edilir.
Özellikle zararlı talepler, manipülasyon girişimleri, yanlış yönlendirmeler ve beklenmeyen kullanım senaryoları incelenebilir.
5. Sürekli Değerlendirme Yapılır
Yeni yetenekler kazanan veya yeni kullanım alanlarında kullanılan modeller yeniden değerlendirilebilir.
Bu nedenle alignment tek seferlik bir eğitim aşamasından ziyade sürekli devam eden bir araştırma ve değerlendirme süreci olarak ele alınabilir.
AI Alignment Neden Önemlidir?
Bir yapay zekâ sisteminin çok güçlü olması, her zaman doğru hedefe yöneldiği anlamına gelmez.
Örneğin bir model:
- Kullanıcının talimatını yanlış yorumlayabilir.
- Hedefi kelimesi kelimesine uygulayıp beklenmeyen bir sonuç oluşturabilir.
- Zararlı bir strateji geliştirebilir.
- İnsanların önem verdiği bazı unsurları göz ardı edebilir.
- Güvenlik sınırlarını aşmaya çalışabilir.
Alignment araştırmalarının amacı bu tür sorunların ortaya çıkma ihtimalini azaltacak yöntemler geliştirmektir.
Özellikle daha otonom AI Agent'ların ve gelecekteki daha güçlü yapay zekâ sistemlerinin geliştirilmesiyle bu konu daha da önemli hâle gelmektedir.
AI Alignment'ın Temel Bileşenleri
Human Feedback
İnsanların model çıktıları hakkındaki değerlendirmeleri, modelin hangi davranışların tercih edildiğini öğrenmesine yardımcı olabilir.
Preference Learning
Model, insanlar tarafından tercih edilen cevap ve davranış örneklerinden öğrenir.
RLHF
Reinforcement Learning from Human Feedback, insan geri bildirimlerini kullanarak model davranışını optimize etmeye yönelik yöntemlerden biridir.
Constitutional AI
Modelin belirli ilke ve kurallara göre kendi çıktısını değerlendirmesine ve geliştirmesine yönelik bir yaklaşımdır.
RLAIF
Reinforcement Learning from AI Feedback, insan yerine yapay zekâ modellerinden alınan geri bildirimlerin kullanılmasını amaçlar.
Safety Evaluation
Modelin farklı risk senaryolarındaki davranışlarının sistematik olarak değerlendirilmesini kapsar.
Red Teaming
Araştırmacılar modelin zayıf noktalarını ve istenmeyen davranışlarını ortaya çıkarmak için kasıtlı olarak zorlayıcı senaryolar oluşturabilir.
AI Alignment Nerelerde Kullanılıyor?
Büyük Dil Modelleri
Chatbot, kodlama asistanı ve genel amaçlı AI sistemlerinin davranışlarının geliştirilmesinde kullanılabilir.
AI Agent
Araç kullanabilen ve uzun süreli görevler gerçekleştiren agent sistemlerinde güvenlik ve kontrol açısından önem taşır.
Sağlık
Tıbbi karar destek sistemlerinin güvenilir ve belirlenen sınırlar içerisinde çalışmasına yönelik araştırmalarda kullanılabilir.
Finans
Finansal analiz ve karar destek sistemlerinde güvenlik, doğruluk ve kullanıcı amaçlarıyla uyum önem taşır.
Eğitim
Öğrencilerin ihtiyaçlarına uygun, güvenli ve doğru yanıtlar üreten AI sistemlerinin geliştirilmesine katkı sağlayabilir.
Robotik
Fiziksel dünyada hareket eden otonom sistemlerin insan talimatları ve güvenlik kurallarıyla uyumlu çalışması açısından önemlidir.
AI Alignment'ın Avantajları
Daha Güvenli Yapay Zekâ
İstenmeyen veya zararlı davranışların azaltılmasına yardımcı olabilir.
Daha Güvenilir Sonuçlar
Modelin kullanıcı talimatlarını ve tercihlerini daha doğru yorumlamasını sağlayabilir.
Daha İyi İnsan-AI Etkileşimi
Yapay zekânın insanların beklentilerine daha uygun davranması kullanım deneyimini geliştirebilir.
Daha Kontrollü Otonomi
AI Agent gibi daha bağımsız sistemlerin belirlenen sınırlar içinde çalışmasına yardımcı olabilir.
Karşılaşılan Zorluklar
İnsan Değerleri Evrensel Değildir
Farklı insanların, toplumların ve kültürlerin doğru veya uygun davranış hakkındaki görüşleri birbirinden farklı olabilir.
Bu nedenle “insan değerleriyle uyumlu” kavramının kendisi bile önemli bir araştırma problemidir.
Alignment'ı Ölçmek Zordur
Bir modelin test sırasında güvenli davranması, her koşulda aynı davranışı göstereceği anlamına gelmeyebilir.
Beklenmeyen Davranışlar
Modellerin yetenekleri ve kullanım biçimleri değiştikçe daha önce görülmemiş davranışlar ortaya çıkabilir.
Alignment ve Capability Birlikte Gelişir
Modelin yetenekleri arttıkça değerlendirilmesi gereken davranışların kapsamı da genişleyebilir.
Tam Çözüm Henüz Yok
Bugünkü alignment teknikleri önemli ilerlemeler sağlamış olsa da güçlü ve genel amaçlı yapay zekâ sistemlerinin tüm olası risklerini çözdüğü söylenemez.
AI Alignment ile AI Safety Arasındaki Fark
AI Safety, yapay zekâ sistemlerinin güvenli şekilde geliştirilmesi, dağıtılması ve kullanılmasına ilişkin daha geniş bir araştırma alanıdır.
AI Alignment ise özellikle yapay zekânın hedefleri, davranışları ve kararlarının insanların amaçları ve tercihleriyle uyumlu olmasına odaklanır.
Bu nedenle iki alan birbirine yakındır ancak tamamen aynı değildir.
AI Alignment ile RLHF Arasındaki Fark
RLHF, insan geri bildirimini kullanarak model davranışını geliştiren belirli bir eğitim yaklaşımıdır.
AI Alignment ise bundan çok daha geniş bir alandır.
RLHF'nin yanı sıra:
- DPO,
- Preference Learning,
- Constitutional AI,
- RLAIF,
- Safety Evaluation,
- Red Teaming
gibi farklı yöntem ve araştırma alanlarını kapsayabilir.
AI Alignment ile Constitutional AI Arasındaki Fark
AI Alignment, yapay zekânın insan amaçları ve değerleriyle uyumlu çalışmasını hedefleyen geniş araştırma alanıdır.
Constitutional AI ise belirlenmiş ilke ve kuralları kullanarak model davranışını şekillendirmeye yönelik özel bir yaklaşımdır.
Dolayısıyla Constitutional AI, alignment araştırmalarındaki yöntemlerden biri olarak değerlendirilebilir.
Gelecekte AI Alignment
AI sistemleri daha yetenekli, çok modlu ve otonom hâle geldikçe alignment araştırmalarının kapsamının da genişlemesi bekleniyor.
Özellikle:
- AGI araştırmaları
- AI Agent sistemleri
- AI Safety
- Reasoning modelleri
- Constitutional AI
- RLAIF
- Scalable Oversight
- Interpretability
gibi alanlar alignment çalışmalarının önemli parçaları olmaya devam edebilir.
Buradaki temel amaç yalnızca daha güçlü yapay zekâ geliştirmek değil, bu sistemlerin güçleri arttıkça güvenli ve öngörülebilir şekilde çalışmasını sağlamak olacaktır.
Sık Sorulan Sorular
AI Alignment nedir?
Yapay zekâ sistemlerinin hedeflerini ve davranışlarını insanların amaçları, tercihleri ve güvenlik beklentileriyle uyumlu hâle getirmeyi amaçlayan araştırma alanıdır.
AI Alignment neden önemlidir?
Yapay zekâ sistemleri daha yetenekli ve otonom hâle geldikçe yanlış hedeflerin veya beklenmeyen davranışların oluşturabileceği riskleri azaltmak önem kazanır.
AI Alignment ile AI Safety aynı mı?
Hayır. AI Safety daha geniş bir güvenlik alanıdır. AI Alignment ise özellikle yapay zekâ davranışlarının insan amaçlarıyla uyumuna odaklanır.
RLHF ile AI Alignment aynı şey mi?
Hayır. RLHF, alignment için kullanılabilecek yöntemlerden biridir. AI Alignment ise çok daha geniş bir araştırma alanıdır.
Constitutional AI alignment yöntemi midir?
Evet. Constitutional AI, belirli ilke ve kurallar kullanarak model davranışını şekillendirmeyi amaçlayan alignment yaklaşımlarından biridir.
RLAIF nedir?
RLAIF, insan geri bildirimi yerine yapay zekâ tarafından oluşturulan geri bildirimleri kullanarak model davranışını geliştirmeyi amaçlayan bir yaklaşımdır.
AI Alignment gelecekte daha önemli olacak mı?
Yapay zekâ sistemlerinin yetenekleri ve otonomileri arttıkça alignment araştırmalarının önemi de artabilir.
AI Alignment AGI ile bağlantılı mı?
Evet. AGI gibi daha genel ve güçlü yapay zekâ sistemlerinin güvenli şekilde geliştirilmesi, alignment araştırmalarının önemli konularından biridir.
AI Alignment tamamen çözülmüş bir problem mi?
Hayır. Günümüzde alignment konusunda önemli ilerlemeler olsa da özellikle daha güçlü ve otonom sistemler için çözülmesi gereken birçok açık problem bulunuyor.
AI Alignment'ın temel amacı nedir?
Yapay zekâ sistemlerinin insanların amaçlarını doğru şekilde anlayıp güvenli, öngörülebilir ve insan tercihleriyle uyumlu biçimde hareket etmesini sağlamaya yönelik yöntemler geliştirmektir.
Kaynaklar
OpenAI Research,Anthropic Research,Google DeepMind Safety Research,Stanford HAI,IEEE Xplore Digital Library,arXiv – AI Alignment araştırmaları,arXiv – Alignment of Large Language Models
Editör Notu
Bu içerik Bitcanlı Editörü tarafından hazırlanmıştır. İçerikte yer alan bilgiler yalnızca bilgilendirme amacı taşımaktadır. AI Alignment, yapay zekâ sistemlerinin insan amaçları, tercihleri ve güvenlik beklentileriyle uyumlu çalışmasını araştıran geniş bir alandır. Teknolojinin hızlı gelişimi nedeniyle güncel akademik çalışmaların, teknik raporların ve güvenilir araştırma kuruluşlarının yayınlarının düzenli olarak takip edilmesi önerilir.






Bunlar da ilginizi çekebilir
-i6a7b8e2f41de7-700x394.png)
Yapay Zekâ Şirketleri Kendi İnternetini Kuruyor: AI Trafiği Neden Bu Kadar Büyüdü?
Yapay zekâ sistemleri büyüdükçe binlerce GPU arasında taşınan veri de artıyor. AI networking teknolojileri, teknoloji şirketlerinin veri merkezi altyapısını yeniden şekillendiriyor.
1 ay önce
Inference Labs Nedir? Doğrulanabilir Yapay Zekâ (Verifiable AI) Altyapısı Nasıl Çalışır?
Yapay zekâ bir sonuç ürettiğinde ona neden güvenelim? Inference Labs, AI çıktılarının gerçekten nasıl üretildiğini kriptografik kanıtlarla doğrulamayı amaçlıyor.
1 ay önce
Atoma Network Nedir? Merkeziyetsiz Yapay Zekâ Çıkarım (AI Inference) Ağı Nasıl Çalışır?
Yapay zekâ çalışırken verileriniz ve modelin kendisi gerçekten güvende mi? Atoma, AI çıkarımını merkeziyetsiz altyapı, doğrulanabilir hesaplama ve gizli işlem teknolojileriyle yeniden ele alıyor.
1 ay önce