
-i6a77249e192b0.png)

Inference Engine Nedir? Büyük Dil Modellerini Çalıştıran Motor Nasıl Çalışır?
Inference Engine, büyük dil modellerinin kullanıcı isteklerine hızlı ve verimli şekilde yanıt vermesini sağlayan kritik yazılım katmanıdır. Peki bu motorlar GPU belleğini, istekleri ve token üretimini nasıl yönetiyor?
23/08/2026 16:15 | Son Güncelleme : 16/09/2026 17:14 | Netosfer
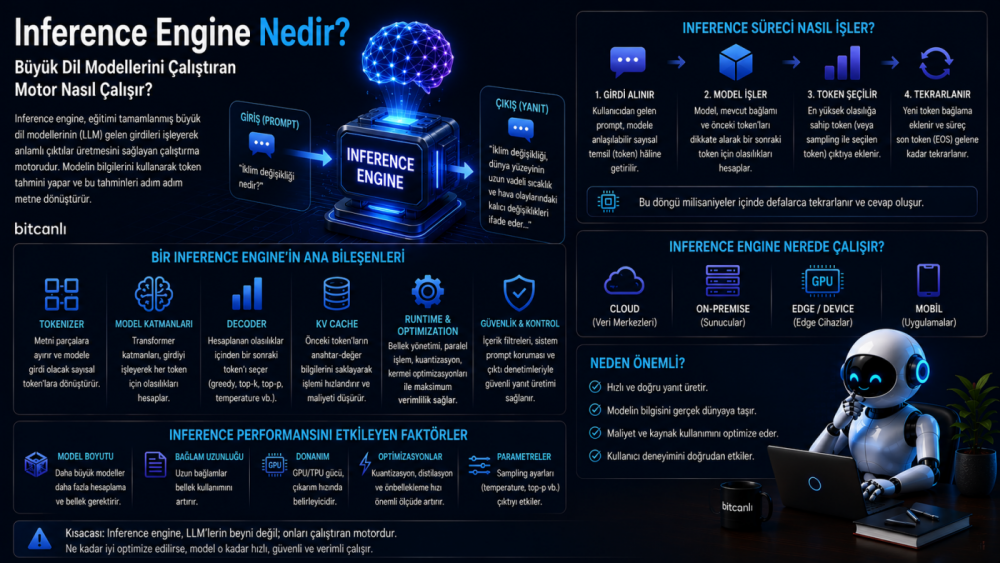
Bir büyük dil modeli (LLM) eğitildikten sonra tek başına kullanıcıya hizmet veremez. Model dosyalarının yüklenmesi, GPU belleğinin yönetilmesi, kullanıcı isteklerinin işlenmesi, token üretimi ve performans optimizasyonları için özel bir yazılım katmanına ihtiyaç vardır.
Bu görevi yerine getiren sistemlere Inference Engine (Çıkarım Motoru) adı verilir.
Bugün ChatGPT benzeri uygulamalarda kullanılan modern LLM altyapılarında vLLM, TensorRT-LLM, SGLang, llama.cpp ve benzeri inference motorları önemli bir rol oynar.
Inference Engine Nedir?
Inference Engine, eğitilmiş yapay zekâ modelini çalıştıran, kullanıcı isteklerini yöneten ve token üretim sürecini optimize eden yazılım altyapısıdır.
Bir Inference Engine;
- Modeli belleğe yükler.
- GPU ve diğer donanım kaynaklarını yönetir.
- Kullanıcı isteklerini işler.
- Token üretimini hızlandırır.
- Bellek kullanımını optimize eder.
Kısaca Inference, modelin çıktı üretme işlemi; Inference Engine ise bu işlemi verimli şekilde gerçekleştiren yazılım katmanıdır.
Inference Engine Nasıl Çalışır?
Genel süreç şu şekilde ilerler:
1. Model Yüklenir
Eğitilmiş LLM modelinin ağırlıkları belleğe alınır.
2. Kullanıcı İstek Gönderir
Kullanıcının prompt'u inference altyapısına ulaşır.
3. Tokenization Yapılır
Metin, modelin işleyebileceği token'lara dönüştürülür.
4. Scheduler Devreye Girer
Birden fazla kullanıcı isteği varsa sistem, bunların nasıl ve ne zaman işleneceğini planlar.
5. Model Çalıştırılır
Transformer katmanları çalıştırılır ve gerekli hesaplamalar gerçekleştirilir.
Bu aşamada KV Cache gibi teknikler tekrar eden hesaplamaları azaltarak performansın artırılmasına yardımcı olabilir.
6. Token Üretilir
Model, yanıtı token token oluşturmaya başlar.
7. Yanıt Kullanıcıya Aktarılır
Streaming destekleniyorsa oluşturulan token'lar yanıt tamamlanmadan kullanıcıya parça parça gönderilebilir.
Inference Engine Neden Önemlidir?
Aynı yapay zekâ modeli, farklı inference altyapılarında farklı performans gösterebilir.
İyi optimize edilmiş bir inference engine;
- Daha düşük gecikme,
- Daha yüksek throughput,
- Daha verimli GPU kullanımı,
- Daha düşük inference maliyeti
sağlayabilir.
Özellikle aynı anda binlerce kullanıcının modelden yanıt aldığı sistemlerde inference altyapısının verimliliği kritik hâle gelir.
Inference Engine'in Temel Bileşenleri
Model Loader
Model ağırlıklarını belleğe yükler ve çalışmaya hazır hâle getirir.
Scheduler
Gelen isteklerin işlenme sırasını ve kaynak kullanımını yönetir.
KV Cache Manager
Transformer modellerinde daha önce hesaplanan anahtar-değer bilgilerini önbelleğe alarak tekrar hesaplama ihtiyacını azaltır.
Batch Manager
Birden fazla isteğin kaynakları daha verimli kullanacak şekilde birlikte işlenmesine yardımcı olur.
Token Generator
Modelin yeni token'lar üretmesini sağlar.
Streaming Engine
Üretilen yanıtın kullanıcıya parça parça aktarılmasını yönetir.
Memory Manager
GPU ve diğer bellek kaynaklarının verimli kullanılmasına yardımcı olur.
Popüler Inference Engine'ler
vLLM
Büyük dil modellerinin yüksek throughput ile sunulmasına odaklanan açık kaynaklı bir LLM serving altyapısıdır. Özellikle PagedAttention ve continuous batching gibi tekniklerle verimli kaynak kullanımını hedefler.
TensorRT-LLM
NVIDIA GPU'ları üzerinde LLM inference performansını optimize etmeye yönelik bir framework'tür.
llama.cpp
LLM'leri CPU ve çeşitli yerel donanımlarda çalıştırmaya odaklanan açık kaynaklı bir projedir.
SGLang
LLM ve multimodal modellerin daha verimli şekilde sunulmasına yönelik bir framework'tür.
Text Generation Inference (TGI)
Hugging Face tarafından geliştirilen ve LLM'lerin üretim ortamında sunulmasına yönelik inference altyapılarından biridir.
Nerelerde Kullanılıyor?
Chatbot ve AI Asistanları
Gerçek zamanlı sohbet sistemlerinde.
AI Agent
Ajanların görevleri yerine getirirken kullandığı modellerin çalıştırılmasında.
Kurumsal AI
Şirket içi LLM servislerinde.
Yerel LLM
Bilgisayarlarda ve diğer yerel cihazlarda model çalıştırmada.
API Servisleri
LLM sağlayıcılarının kullanıcı isteklerine yanıt veren sunucu altyapılarında.
Inference Engine'in Avantajları
Daha Hızlı Yanıt
Model çalıştırma sürecini optimize ederek gecikmenin azaltılmasına yardımcı olabilir.
Daha Verimli GPU Kullanımı
GPU kaynaklarının daha etkin kullanılmasını sağlar.
Daha Fazla Kullanıcı
Aynı donanımla daha fazla isteğin işlenmesine yardımcı olabilir.
Daha Düşük Maliyet
Kaynakların daha verimli kullanılması inference maliyetlerini azaltabilir.
Esnek Model Desteği
Desteklenen altyapıya bağlı olarak farklı model mimarileri çalıştırılabilir.
Karşılaşılan Zorluklar
GPU Belleği
Büyük modeller yüksek miktarda VRAM gerektirebilir.
Scheduler Tasarımı
Yoğun trafikte isteklerin doğru şekilde planlanması karmaşık hâle gelebilir.
Donanım Uyumluluğu
Farklı GPU ve işlemci mimarileri farklı optimizasyonlar gerektirebilir.
Model Uyumluluğu
Yeni model mimarilerinin inference altyapılarına eklenmesi zaman alabilir.
Sürekli Optimizasyon
Model boyutları ve kullanım yoğunluğu arttıkça bellek ve hesaplama yönetiminin sürekli iyileştirilmesi gerekir.
Inference Engine ile Inference Arasındaki Fark
Inference
Eğitilmiş modelin verilen girdiden çıktı üretme işlemidir.
Inference Engine
Bu çıkarım işlemini gerçekleştiren ve kaynak kullanımını yöneten yazılım altyapısıdır.
Kısaca:
Inference = İşlem
Inference Engine = İşlemi gerçekleştiren motor
Inference Engine ile AI Gateway Arasındaki Fark
AI Gateway
Gelen istekleri yönetir ve gerektiğinde uygun modele veya modele ait servise yönlendirir.
Inference Engine
Seçilen modeli gerçekten çalıştırır ve çıktıyı üretir.
Bu iki katman aynı sistem içinde birlikte kullanılabilir.
Gelecekte Inference Engine
Büyük dil modellerinin daha fazla kullanıcı ve uygulama tarafından kullanılmaya devam etmesiyle inference altyapısının önemi de artacaktır.
Gelecekte;
- Continuous Batching ve Speculative Decoding gibi optimizasyonların daha yaygın kullanılması,
- Çok GPU'lu ve dağıtık inference altyapılarının gelişmesi,
- AI Gateway ve inference engine'lerin daha sık birlikte çalışması,
- Çok büyük modeller için yeni bellek yönetimi tekniklerinin geliştirilmesi,
- Yerel LLM'ler için daha hafif ve verimli inference motorlarının yaygınlaşması
beklenmektedir.
Sık Sorulan Sorular
Inference Engine nedir?
Eğitilmiş yapay zekâ modellerini çalıştıran, donanım kaynaklarını yöneten ve çıktı üretim sürecini optimize eden yazılım altyapısıdır.
Inference Engine neden önemlidir?
LLM'lerin daha hızlı, daha verimli ve daha düşük maliyetle çalıştırılmasına yardımcı olur.
vLLM bir Inference Engine midir?
Evet. vLLM, LLM serving ve inference için kullanılan açık kaynaklı bir altyapıdır.
Inference Engine modeli eğitir mi?
Hayır. Temel görevi eğitilmiş modeli çalıştırmak ve inference sürecini yönetmektir.
Gelecekte daha yaygın olacak mı?
Evet. LLM'lerin uygulamalarda kullanımının artmasıyla birlikte hızlı ve verimli inference altyapıları daha da önemli hâle gelecektir.
Kaynaklar
vLLM Documentation, NVIDIA TensorRT-LLM Documentation, Hugging Face Text Generation Inference (TGI), llama.cpp Documentation, IEEE Xplore Digital Library, arXiv – Efficient LLM Serving Systems: A Survey
Editör Notu
Bu içerik Bitcanli Editörü tarafından hazırlanmıştır. İçerikte yer alan bilgiler yalnızca bilgilendirme amacı taşımaktadır. Inference Engine teknolojileri ve LLM sunum altyapıları hızla gelişmektedir. Güncel akademik araştırmaların, teknik raporların ve açık kaynak projelerin düzenli olarak takip edilmesi önerilir.






Bunlar da ilginizi çekebilir
-i6a7b8e2f41de7-700x394.png)
Yapay Zekâ Şirketleri Kendi İnternetini Kuruyor: AI Trafiği Neden Bu Kadar Büyüdü?
Yapay zekâ sistemleri büyüdükçe binlerce GPU arasında taşınan veri de artıyor. AI networking teknolojileri, teknoloji şirketlerinin veri merkezi altyapısını yeniden şekillendiriyor.
1 ay önce
Inference Labs Nedir? Doğrulanabilir Yapay Zekâ (Verifiable AI) Altyapısı Nasıl Çalışır?
Yapay zekâ bir sonuç ürettiğinde ona neden güvenelim? Inference Labs, AI çıktılarının gerçekten nasıl üretildiğini kriptografik kanıtlarla doğrulamayı amaçlıyor.
1 ay önce
Atoma Network Nedir? Merkeziyetsiz Yapay Zekâ Çıkarım (AI Inference) Ağı Nasıl Çalışır?
Yapay zekâ çalışırken verileriniz ve modelin kendisi gerçekten güvende mi? Atoma, AI çıkarımını merkeziyetsiz altyapı, doğrulanabilir hesaplama ve gizli işlem teknolojileriyle yeniden ele alıyor.
1 ay önce