
-i6a77249e192b0.png)

PEFT Nedir? Büyük Dil Modelleri Düşük Maliyetle Nasıl Fine-Tuning Yapıyor?
PEFT, büyük dil modellerinin tamamını yeniden eğitmeden yalnızca küçük bir parametre bölümünü güncelleyerek daha düşük maliyetle özelleştirilmesini sağlıyor. Peki LoRA ve QLoRA gibi yöntemler bu süreci nasıl değiştiriyor?
23/08/2026 15:40 | Son Güncelleme : 16/09/2026 18:54 | Netosfer
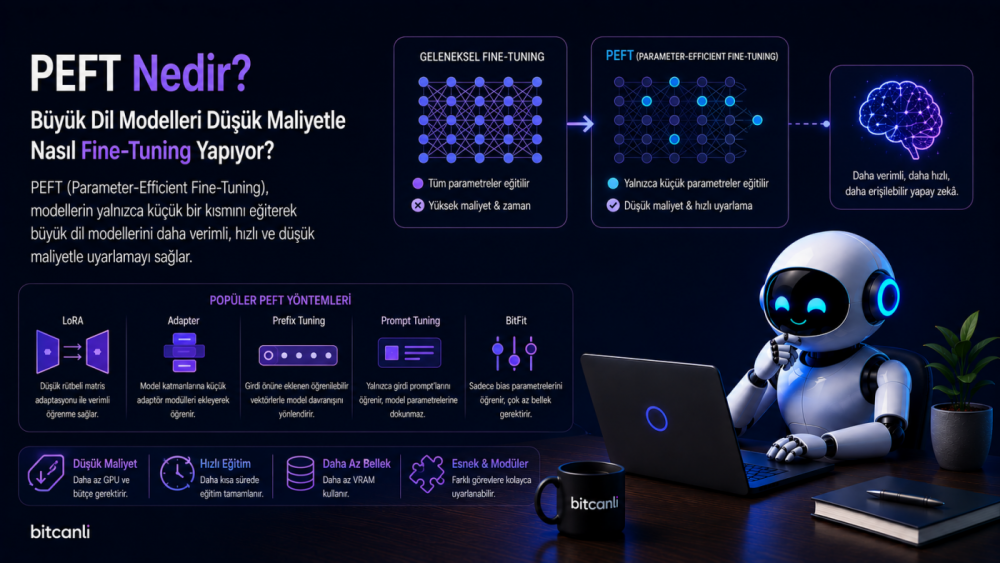
Büyük dil modellerini (LLM) tamamen yeniden eğitmek, milyarlarca parametrenin güncellenmesini gerektirebilir. Bu süreç yüksek GPU gücü, geniş bellek kapasitesi ve ciddi hesaplama maliyetleri anlamına gelir.
Bu soruna çözüm olarak geliştirilen Parameter-Efficient Fine-Tuning (PEFT) yöntemleri, modelin tamamını değiştirmek yerine yalnızca küçük bir bölümünü eğiterek belirli görevlerde modeli özelleştirmeyi amaçlar.
LoRA, QLoRA, Prefix Tuning, Prompt Tuning ve Adapter Tuning gibi yöntemler PEFT yaklaşımı içinde yer alır. Böylece büyük modeller, daha sınırlı donanım kaynaklarıyla farklı kullanım alanlarına uyarlanabilir.
PEFT Nedir?
PEFT (Parameter-Efficient Fine-Tuning), büyük yapay zekâ modellerini özelleştirirken modelin tüm parametrelerini güncellemek yerine yalnızca küçük bir bölümünün eğitildiği Fine-Tuning yöntemlerinin genel adıdır.
Bu yaklaşım sayesinde;
- GPU belleği daha verimli kullanılabilir.
- Eğitim maliyeti azaltılabilir.
- Büyük modeller daha düşük donanım gereksinimiyle özelleştirilebilir.
- Farklı görevler için küçük adaptörler oluşturulabilir.
PEFT tek bir algoritma değildir. Farklı yöntemleri kapsayan genel bir Fine-Tuning yaklaşımıdır.
PEFT Nasıl Çalışır?
Genel süreç şu şekilde ilerler:
1. Önceden Eğitilmiş Model Yüklenir
Örneğin;
- Llama
- Gemma
- Qwen
- Mistral
gibi önceden eğitilmiş bir temel model kullanılabilir.
2. Temel Model Dondurulur
Modelin büyük bölümünü oluşturan mevcut parametreler eğitim sırasında değiştirilmez.
3. Eğitilebilir Parametreler Eklenir
Göreve uygun küçük adaptörler veya öğrenilebilir parametreler modele eklenir.
4. Fine-Tuning Yapılır
Eğitim sırasında esas olarak bu küçük parametreler güncellenir.
5. Özelleştirilmiş Model Kullanılır
Temel model korunurken eklenen parametreler belirli görevlerdeki davranışı değiştirmek için kullanılabilir.
PEFT Neden Önemlidir?
Full Fine-Tuning sırasında modelin bütün parametrelerinin güncellenmesi büyük miktarda hesaplama ve bellek gerektirebilir.
PEFT yaklaşımı ise daha az parametreyi eğiterek bu yükü azaltmayı amaçlar.
Bunun sonucunda;
- Daha düşük donanım gereksinimi,
- Daha düşük eğitim maliyeti,
- Daha küçük model eklentileri,
- Daha kolay görev bazlı özelleştirme
mümkün olabilir.
PEFT Yöntemleri
LoRA
Low-Rank Adaptation (LoRA)****, büyük modellerin belirli katmanlarına düşük dereceli eğitilebilir matrisler ekleyerek az sayıda parametrenin güncellenmesini sağlar.
Günümüzde en yaygın PEFT yaklaşımlarından biridir.
QLoRA
QLoRA, LoRA yaklaşımını düşük bitli Quantization teknikleriyle birleştirir.
Bu sayede özellikle büyük modellerin daha sınırlı GPU belleğiyle eğitilmesi mümkün olabilir.
Prompt Tuning
Modelin ana parametreleri yerine öğrenilebilir prompt temsilleri optimize edilir.
Prefix Tuning
Transformer katmanlarının girişlerine öğrenilebilir prefix temsilleri eklenerek model belirli görevlere uyarlanır.
Adapter Tuning
Model katmanları arasına küçük eğitilebilir modüller eklenir.
IA³
Modelin belirli aktivasyonlarını veya katmanlarını ölçekleyen küçük sayıdaki parametreyi öğrenerek verimli Fine-Tuning gerçekleştirmeyi amaçlar.
PEFT'in Avantajları
Daha Az GPU Belleği
Daha az parametre güncellendiği için eğitim sırasında bellek kullanımı azaltılabilir.
Daha Düşük Maliyet
Daha düşük hesaplama ve donanım ihtiyacı sayesinde eğitim maliyeti düşebilir.
Daha Küçük Model Eklentileri
Temel modelin tamamını yeniden saklamak yerine yalnızca eğitilen adaptörler dağıtılabilir.
Daha Kolay Özelleştirme
Aynı temel model farklı görevler için farklı PEFT adaptörleriyle özelleştirilebilir.
Daha Kolay Model Yönetimi
Farklı görevler için oluşturulan küçük adaptörler ayrı ayrı saklanabilir ve gerektiğinde temel modele bağlanabilir.
Karşılaşılan Zorluklar
Göreve Bağımlılık
Her PEFT yöntemi her görevde aynı performansı göstermeyebilir.
Performans Farkı
Bazı görevlerde Full Fine-Tuning, PEFT yöntemlerinden daha yüksek performans sağlayabilir.
Yöntem Seçimi
LoRA, QLoRA, Prefix Tuning veya Adapter Tuning arasında doğru yöntemi seçmek model ve kullanım senaryosuna bağlıdır.
Adaptör Yönetimi
Çok sayıda adaptör kullanıldığında sürüm, uyumluluk ve dağıtım yönetimi önem kazanır.
Nerelerde Kullanılıyor?
Kurumsal AI
Şirket ihtiyaçlarına göre temel modelleri özelleştirmede.
AI Agent
Belirli görevlerde uzmanlaşmış model bileşenleri geliştirmede.
Sağlık
Tıbbi metin ve dokümanlarla çalışan modellerin özelleştirilmesinde.
Hukuk
Hukuki belgeleri ve alan terminolojisini işleyen modellerde.
Finans
Finansal metin ve kurum içi veriler üzerinde çalışan modellerin uyarlanmasında.
Yerel LLM
Sınırlı GPU kaynaklarına sahip ortamlarda model özelleştirmede.
PEFT ile LoRA Arasındaki Fark
PEFT
Parameter-Efficient Fine-Tuning yöntemlerinin genel adıdır.
LoRA
PEFT ailesindeki belirli yöntemlerden biridir.
Kısacası:
LoRA ⊂ PEFT
Her LoRA uygulaması PEFT kapsamındadır ancak her PEFT yöntemi LoRA değildir.
PEFT ile Full Fine-Tuning Arasındaki Fark
Full Fine-Tuning
Modelin çok büyük bölümündeki veya tüm parametrelerindeki ağırlıklar güncellenir.
PEFT
Modelin küçük bir parametre bölümünün veya eklenen adaptörlerin eğitilmesine odaklanır.
Bu nedenle PEFT, özellikle büyük modellerde eğitim kaynaklarını azaltmak için önemli bir seçenek olabilir.
Gelecekte PEFT
PEFT yöntemlerinin özellikle büyük açık kaynak modellerin özelleştirilmesinde önemli rol oynamaya devam etmesi beklenmektedir.
Önümüzdeki dönemde;
- Daha verimli PEFT yöntemleri geliştirilebilir.
- Büyük modeller daha düşük donanımla özelleştirilebilir.
- Edge AI cihazlarında kullanım artabilir.
- AI Agent sistemleri görev bazlı adaptörlerle özelleştirilebilir.
- Quantization ve diğer model sıkıştırma teknikleriyle daha sık birlikte kullanılabilir.
PEFT'in temel avantajı, büyük modelleri tamamen yeniden eğitmek yerine daha küçük ve yönetilebilir parametre grupları üzerinden özelleştirme imkânı sunmasıdır.
Sık Sorulan Sorular
PEFT nedir?
Büyük yapay zekâ modellerinin yalnızca küçük bir bölümünü eğiterek özelleştirilmesini sağlayan Fine-Tuning yöntemlerinin genel adıdır.
PEFT neden önemlidir?
Eğitim sırasında gereken GPU belleğini, hesaplama miktarını ve maliyeti azaltmaya yardımcı olabilir.
LoRA ile aynı mı?
Hayır. LoRA, PEFT ailesindeki yöntemlerden yalnızca biridir.
QLoRA nedir?
QLoRA, LoRA'yı Quantization ile birleştirerek büyük modellerin daha düşük bellek kullanımıyla Fine-Tuning edilmesini amaçlayan yöntemdir.
PEFT Full Fine-Tuning'in yerini tamamen alır mı?
Her durumda değil. Göreve, modele ve performans hedeflerine bağlı olarak Full Fine-Tuning hâlâ daha uygun olabilir.
Gelecekte daha yaygın olacak mı?
Özellikle açık kaynak LLM'lerin özelleştirilmesi, kurumsal yapay zekâ ve sınırlı donanım kaynaklarına sahip sistemlerde PEFT kullanımının artması beklenmektedir.
Kaynaklar
Hugging Face – PEFT Documentation, Microsoft Research – LoRA, IBM – Parameter-Efficient Fine-Tuning, IEEE Xplore Digital Library, arXiv – Parameter-Efficient Fine-Tuning for Large Models: A Comprehensive Survey, arXiv – Scaling Down to Scale Up: A Guide to Parameter-Efficient Fine-Tuning
Editör Notu
Bu içerik Bitcanlı Editörü tarafından hazırlanmıştır. İçerikte yer alan bilgiler yalnızca bilgilendirme amacı taşımaktadır. PEFT yöntemleri, büyük dil modellerinin daha düşük hesaplama ve bellek gereksinimleriyle özelleştirilmesini sağlayan önemli Fine-Tuning yaklaşımları arasında yer almaktadır. Güncel akademik araştırmaların, teknik raporların ve açık kaynak projelerin düzenli olarak takip edilmesi önerilir.






Bunlar da ilginizi çekebilir
-i6a7b8e2f41de7-700x394.png)
Yapay Zekâ Şirketleri Kendi İnternetini Kuruyor: AI Trafiği Neden Bu Kadar Büyüdü?
Yapay zekâ sistemleri büyüdükçe binlerce GPU arasında taşınan veri de artıyor. AI networking teknolojileri, teknoloji şirketlerinin veri merkezi altyapısını yeniden şekillendiriyor.
1 ay önce
Inference Labs Nedir? Doğrulanabilir Yapay Zekâ (Verifiable AI) Altyapısı Nasıl Çalışır?
Yapay zekâ bir sonuç ürettiğinde ona neden güvenelim? Inference Labs, AI çıktılarının gerçekten nasıl üretildiğini kriptografik kanıtlarla doğrulamayı amaçlıyor.
1 ay önce
Atoma Network Nedir? Merkeziyetsiz Yapay Zekâ Çıkarım (AI Inference) Ağı Nasıl Çalışır?
Yapay zekâ çalışırken verileriniz ve modelin kendisi gerçekten güvende mi? Atoma, AI çıkarımını merkeziyetsiz altyapı, doğrulanabilir hesaplama ve gizli işlem teknolojileriyle yeniden ele alıyor.
1 ay önce