
-i6a77249e192b0.png)

Quantization Nedir? Yapay Zekâ Modelleri Nasıl Daha Az Bellek Kullanıyor?
Quantization, milyarlarca parametreye sahip yapay zekâ modellerini daha düşük bit hassasiyetiyle temsil ederek bellek kullanımını ve çıkarım maliyetini azaltıyor. Peki INT4, INT8, GPTQ ve AWQ gibi yöntemler nasıl çalışıyor?
23/08/2026 15:43 | Son Güncelleme : 16/09/2026 18:53 | Netosfer
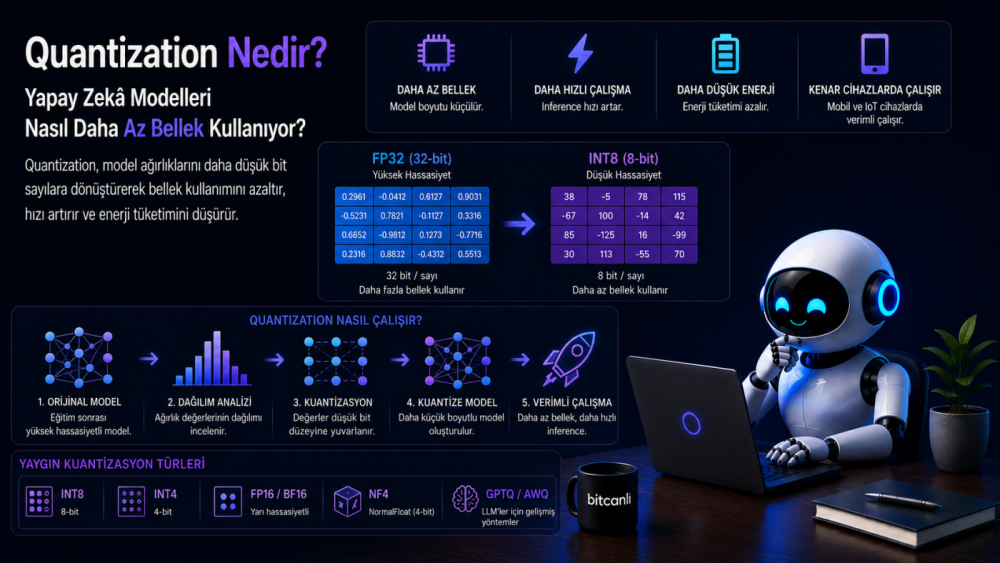
Büyük dil modelleri (LLM), milyarlarca parametre içerdiği için yüksek miktarda RAM ve GPU belleğine ihtiyaç duyabilir. Özellikle büyük modellerin tam hassasiyetle çalıştırılması, donanım gereksinimlerini ve çıkarım maliyetlerini önemli ölçüde artırabilir.
Bu soruna çözüm olarak kullanılan Quantization (Kuantizasyon), model ağırlıklarını ve bazı hesaplamaları daha düşük hassasiyetli sayısal biçimlerle temsil ederek bellek kullanımını azaltmayı amaçlayan bir model optimizasyon tekniğidir.
INT8, INT4, FP8, GPTQ ve AWQ gibi yöntemler, büyük modellerin daha sınırlı donanımlarda çalıştırılmasına yardımcı olabilir.
Quantization Nedir?
Quantization, yapay zekâ modelindeki ağırlıkların ve gerektiğinde aktivasyonların daha düşük bit genişliğiyle temsil edilmesini sağlayan optimizasyon yaklaşımıdır.
Bu sayede;
- Modelin bellek gereksinimi azaltılabilir.
- Bazı donanımlarda çıkarım hızlandırılabilir.
- GPU ve CPU kaynakları daha verimli kullanılabilir.
- Büyük modellerin yerel cihazlarda çalıştırılması kolaylaşabilir.
Quantization özellikle Inference aşamasında büyük modellerin daha verimli çalıştırılması için yaygın olarak kullanılır.
Quantization Nasıl Çalışır?
Genel süreç şu şekilde ilerler:
1. Eğitilmiş Model Alınır
Model, genellikle FP32 veya FP16 gibi daha yüksek hassasiyetli sayısal temsillerle hazırlanmıştır.
2. Sayısal Hassasiyet Azaltılır
Örneğin;
FP32 → FP16 → INT8 → INT4
gibi daha düşük bitli temsillere geçilebilir.
3. Kuantizasyon Parametreleri Belirlenir
Model ağırlıklarının yeni sayısal aralığa nasıl dönüştürüleceği belirlenir.
4. Model Dönüştürülür
Ağırlıklar seçilen kuantizasyon yöntemine göre daha düşük hassasiyetle temsil edilir.
5. Performans Testi Yapılır
Bellek kullanımı, çıkarım hızı ve model doğruluğundaki değişiklikler değerlendirilir.
6. Model Kullanıma Sunulur
Optimize edilmiş model hedef donanımda çalıştırılır.
Bit Genişliği Nedir?
Bit genişliği, bir sayısal değerin bellekte kaç bit kullanılarak temsil edildiğini ifade eder.
Örneğin;
- FP32 → 32 bit
- FP16 → 16 bit
- INT8 → 8 bit
- INT4 → 4 bit
Genel olarak bit genişliği azaldıkça modelin bellek ihtiyacı da azalır. Ancak çok agresif kuantizasyon, modelin doğruluğunu ve görev performansını olumsuz etkileyebilir.
Quantization Neden Önemlidir?
Kuantizasyon kullanılmadığında büyük modeller yüksek miktarda VRAM ve RAM gerektirebilir. Bu durum özellikle yerel bilgisayarlar, mobil cihazlar ve sınırlı GPU kaynaklarına sahip sistemlerde önemli bir engel oluşturur.
Quantization sayesinde;
- Daha küçük GPU'larda model çalıştırılabilir.
- Bellek kullanımı azaltılabilir.
- Sunucu başına daha fazla model çalıştırılabilir.
- Inference maliyetleri düşürülebilir.
- Yerel yapay zekâ uygulamaları daha erişilebilir hâle gelebilir.
Quantization Türleri
Dynamic Quantization
Bazı değerlerin kuantizasyonu çalışma sırasında gerçekleştirilir. Özellikle belirli CPU tabanlı çıkarım senaryolarında kullanılabilir.
Static Quantization
Kuantizasyon parametreleri model çalıştırılmadan önce belirlenir ve model önceden dönüştürülür.
Post-Training Quantization (PTQ)
Model eğitimi tamamlandıktan sonra kuantizasyon uygulanır.
Quantization-Aware Training (QAT)
Model eğitim sırasında kuantizasyon etkilerini dikkate alacak şekilde eğitilir. Bu yaklaşım, bazı durumlarda düşük hassasiyetli çıkarım sonrasında oluşabilecek performans kaybını azaltmaya yardımcı olabilir.
Popüler Quantization Yöntemleri
GPTQ
Özellikle büyük dil modellerinin post-training quantization işlemlerinde kullanılan bir yöntemdir.
AWQ
Model performansını mümkün olduğunca korurken ağırlıkları düşük bitli biçimlerde temsil etmeyi amaçlayan LLM kuantizasyon yaklaşımıdır.
GGUF
Özellikle yerel LLM çalıştırma ekosisteminde kullanılan bir model dosya formatıdır. GGUF doğrudan bir kuantizasyon algoritması değil, kuantize edilmiş modelleri de taşıyabilen bir dosya formatıdır.
BitsAndBytes
LLM'lerin düşük hassasiyetli biçimlerde yüklenmesi ve eğitilmesi için kullanılan popüler açık kaynak araçlarından biridir.
Nerelerde Kullanılıyor?
Yerel LLM
Kişisel bilgisayarlarda büyük modeller çalıştırmada.
Edge AI
Mobil ve sınırlı donanıma sahip cihazlarda.
Robotik
Gerçek zamanlı yapay zekâ uygulamalarında.
Kurumsal AI
Inference altyapısındaki GPU ve bellek maliyetlerini azaltmada.
Bulut Yapay Zekâ
Büyük ölçekli model servislerinde çıkarım optimizasyonunda.
IoT
Sınırlı işlem gücüne sahip cihazlarda yapay zekâ modellerinin çalıştırılmasında.
Quantization'ın Avantajları
Daha Az Bellek
Daha düşük bitli temsil, model ağırlıklarının kapladığı alanı azaltabilir.
Daha Hızlı Inference
Destekleyen donanımlarda düşük hassasiyetli hesaplamalar çıkarım hızını artırabilir.
Daha Düşük Enerji Tüketimi
Daha az bellek ve hesaplama kullanımı bazı cihazlarda enerji tüketimini azaltabilir.
Daha Düşük Donanım Gereksinimi
Büyük modellerin daha sınırlı donanımlarda çalıştırılmasına yardımcı olabilir.
Karşılaşılan Zorluklar
Doğruluk Kaybı
Bit genişliği düşürüldükçe model performansında kayıp oluşabilir.
Donanım Uyumluluğu
Her donanım tüm düşük hassasiyet formatlarını aynı şekilde desteklemez.
Model Hassasiyeti
Bazı modeller veya katmanlar kuantizasyona diğerlerinden daha duyarlı olabilir.
Yöntem Seçimi
Model, donanım ve kullanım amacına göre uygun kuantizasyon yönteminin seçilmesi gerekir.
Quantization ile Model Distillation Arasındaki Fark
Quantization
Mevcut modelin ağırlıkları daha düşük hassasiyetli sayısal temsillerle ifade edilir.
Model Distillation
Büyük bir teacher model, daha küçük bir student model eğitmek için kullanılır.
Yani Quantization mevcut modeli daha verimli temsil etmeye, Distillation ise yeni ve daha küçük bir model oluşturmaya odaklanır.
Quantization ile Pruning Arasındaki Fark
Pruning
Modeldeki bazı ağırlıkların veya bağlantıların kaldırılmasını hedefler.
Quantization
Ağırlıkları kaldırmak yerine onların daha düşük hassasiyetle temsil edilmesini sağlar.
Bu nedenle iki yöntem birlikte de kullanılabilir.
Gelecekte Quantization
Büyük yapay zekâ modellerinin daha düşük maliyetle çalıştırılması açısından Quantization'ın öneminin artması beklenmektedir.
Özellikle;
- INT4 ve benzeri düşük bitli formatların kullanımı artabilir.
- FP8 gibi düşük hassasiyetli hesaplama formatları daha fazla donanım tarafından desteklenebilir.
- Yerel LLM uygulamaları yaygınlaşabilir.
- Edge AI cihazlarında daha büyük modeller çalıştırılabilir.
- Quantization, model optimizasyonu ve deployment süreçlerinin temel bileşenlerinden biri olmaya devam edebilir.
Sık Sorulan Sorular
Quantization nedir?
Yapay zekâ modelindeki ağırlıkları ve bazı hesaplamaları daha düşük bit genişliğiyle temsil ederek bellek ve hesaplama gereksinimini azaltmayı amaçlayan optimizasyon tekniğidir.
Quantization neden önemlidir?
Büyük modellerin daha düşük donanım kaynaklarıyla çalıştırılmasına yardımcı olur ve uygun donanımlarda Inference maliyetini azaltabilir.
Quantization doğruluğu etkiler mi?
Evet. Özellikle düşük bit seviyelerinde model performansında kayıp oluşabilir. Ancak uygun yöntem ve kalibrasyonla bu kayıp sınırlandırılabilir.
GGUF bir Quantization yöntemi midir?
Hayır. GGUF bir model dosya formatıdır. Kuantize edilmiş modeller GGUF formatında dağıtılabilir.
Quantization ile Fine-Tuning aynı mı?
Hayır. Quantization temel olarak modelin daha verimli temsil edilmesine odaklanırken Fine-Tuning modelin belirli bir göreve uyarlanmasını amaçlar.
Gelecekte daha yaygın olacak mı?
Özellikle yerel LLM, Edge AI, mobil yapay zekâ ve büyük ölçekli Inference altyapılarında Quantization kullanımının artması beklenmektedir.
Kaynaklar
NVIDIA TensorRT-LLM Documentation, Hugging Face – Quantization Documentation, BitsAndBytes Documentation, IEEE Xplore Digital Library, arXiv – A Survey of Quantization Methods for Large Language Models, arXiv – GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers, arXiv – AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration
Editör Notu
Bu içerik Bitcanlı Editörü tarafından hazırlanmıştır. İçerikte yer alan bilgiler yalnızca bilgilendirme amacı taşımaktadır. Quantization, büyük yapay zekâ modellerinin bellek ve hesaplama gereksinimlerini azaltarak daha verimli şekilde çalıştırılmasını sağlayan önemli model optimizasyon tekniklerinden biridir. Güncel teknik dokümantasyonun, akademik araştırmaların ve açık kaynak projelerin düzenli olarak takip edilmesi önerilir.






Bunlar da ilginizi çekebilir
-i6a7b8e2f41de7-700x394.png)
Yapay Zekâ Şirketleri Kendi İnternetini Kuruyor: AI Trafiği Neden Bu Kadar Büyüdü?
Yapay zekâ sistemleri büyüdükçe binlerce GPU arasında taşınan veri de artıyor. AI networking teknolojileri, teknoloji şirketlerinin veri merkezi altyapısını yeniden şekillendiriyor.
1 ay önce
Inference Labs Nedir? Doğrulanabilir Yapay Zekâ (Verifiable AI) Altyapısı Nasıl Çalışır?
Yapay zekâ bir sonuç ürettiğinde ona neden güvenelim? Inference Labs, AI çıktılarının gerçekten nasıl üretildiğini kriptografik kanıtlarla doğrulamayı amaçlıyor.
1 ay önce
Atoma Network Nedir? Merkeziyetsiz Yapay Zekâ Çıkarım (AI Inference) Ağı Nasıl Çalışır?
Yapay zekâ çalışırken verileriniz ve modelin kendisi gerçekten güvende mi? Atoma, AI çıkarımını merkeziyetsiz altyapı, doğrulanabilir hesaplama ve gizli işlem teknolojileriyle yeniden ele alıyor.
1 ay önce