
-i6a77249e192b0.png)

Red Teaming Nedir? Yapay Zekâ Modellerinin Güvenliği Nasıl Test Ediliyor?
Red Teaming, yapay zekâ modellerini kontrollü saldırı ve stres testleriyle zorlayarak güvenlik açıklarını ortaya çıkarmayı amaçlar. Peki yapay zekâ sistemleri üretime alınmadan önce hangi risklere karşı test ediliyor?
23/08/2026 16:08 | Son Güncelleme : 16/09/2026 18:11 | Netosfer
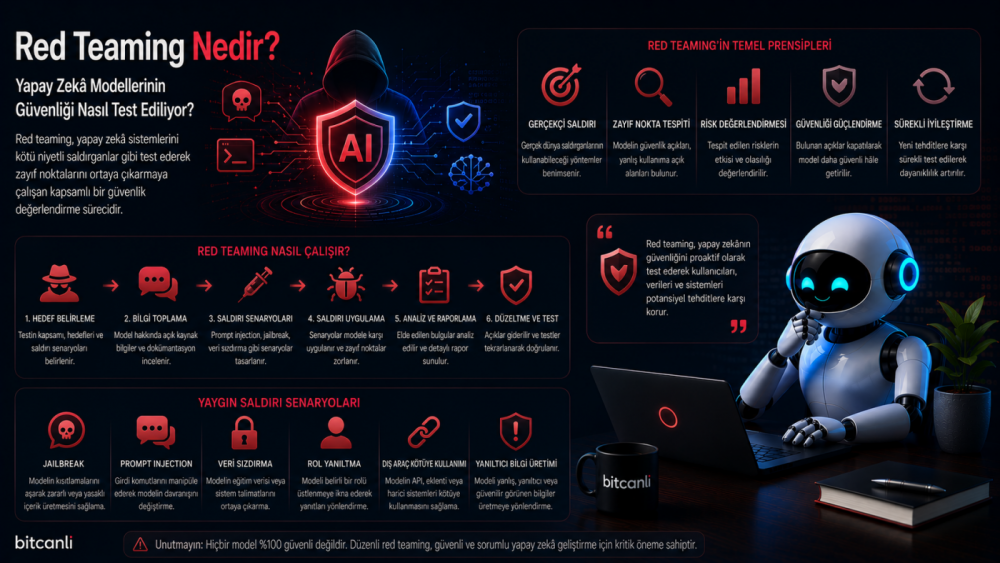
Bir yapay zekâ modeli laboratuvar ortamında başarılı sonuçlar verebilir. Ancak gerçek dünyada kullanıcılar modele beklenmedik sorular sorabilir, güvenlik açıklarını zorlayabilir veya sistemi kötüye kullanmaya çalışabilir.
Bu nedenle modern yapay zekâ geliştirme süreçlerinde yalnızca performans testleri yeterli görülmez. Modeller, kasıtlı olarak zorlayıcı ve saldırgan senaryolarla test edilir. Bu sürece Red Teaming adı verilir.
OpenAI, Anthropic, Google DeepMind, Microsoft ve Meta gibi şirketler, yeni modellerini kullanıma sunmadan önce farklı güvenlik testleri ve Red Teaming çalışmaları yürütmektedir.
Red Teaming Nedir?
Red Teaming, bir yapay zekâ modelinin güvenlik açıklarını, zayıf yönlerini ve beklenmeyen davranışlarını ortaya çıkarmak amacıyla gerçekleştirilen kontrollü saldırı ve stres testi sürecidir.
Amaç;
- Güvenlik açıklarını bulmak,
- Zararlı davranışları tespit etmek,
- Modeli üretim öncesinde güçlendirmek,
- Kullanıcı güvenliğini artırmaktır.
Red Teaming Nasıl Çalışır?
Genel süreç şu şekildedir:
1. Test Senaryoları Hazırlanır
Örneğin;
- Zararlı istemler
- Jailbreak denemeleri
- Prompt Injection saldırıları
- Hassas veri talepleri
- Araç kötüye kullanımı
2. Model Test Edilir
Model farklı saldırı ve stres senaryolarıyla karşı karşıya bırakılır.
3. Sonuçlar Analiz Edilir
Modelin hangi durumlarda beklenmeyen veya riskli davranışlar sergilediği incelenir.
4. Güvenlik Açıkları Belirlenir
Tespit edilen riskli davranışlar belgelenir ve önem derecelerine göre değerlendirilir.
5. Model ve Güvenlik Katmanları İyileştirilir
Guardrails, sistem talimatları, araç izinleri veya diğer güvenlik mekanizmaları geliştirilebilir.
Red Teaming Neden Önemlidir?
Gerçek kullanıcı davranışlarını önceden tamamen tahmin etmek mümkün değildir.
Bir model;
- Hassas bilgi paylaşabilir,
- Yanlış yönlendirme yapabilir,
- Güvenlik kurallarını aşabilir,
- Yetkili araçları beklenmeyen şekilde kullanabilir.
Red Teaming sayesinde bu tür risklerin bir bölümü sistem üretime alınmadan önce ortaya çıkarılabilir.
Red Teaming Türleri
Prompt Injection Testleri
Modelin talimat manipülasyonlarına karşı dayanıklılığı ölçülür.
Jailbreak Testleri
Modelin güvenlik sınırlarının aşılmaya çalışıldığı senaryolar test edilir.
Data Leakage Testleri
Modelin hassas veya yetkisiz bilgileri açığa çıkarıp çıkarmadığı incelenir.
Tool Abuse Testleri
AI Agent'ın erişebildiği araçların amaç dışı kullanılmasına yönelik riskler araştırılır.
Bias Testleri
Modelin farklı gruplara veya senaryolara karşı sistematik olarak önyargılı davranıp davranmadığı değerlendirilir.
Hallucination Testleri
Modelin yanlış veya doğrulanmamış bilgiler üretme eğilimi incelenir.
Nerelerde Kullanılıyor?
Büyük Dil Modelleri
Yeni model ve model sürümleri yayınlanmadan önce.
AI Agent
Araç kullanımı ve otonom görevlerin güvenliğinde.
Kurumsal Yapay Zekâ
Şirket sistemleri ve hassas verilerle çalışan uygulamalarda.
Sağlık
Hasta verileri ve kritik karar süreçlerinde.
Finans
Yetkisiz işlemler ve finansal risklerin değerlendirilmesinde.
Kamu Kurumları
Yüksek güvenlik ve güvenilirlik gerektiren yapay zekâ uygulamalarında.
Red Teaming'in Avantajları
Güvenlik Açıklarını Ortaya Çıkarır
Gerçek saldırı senaryolarına benzeyen kontrollü testler yapılmasını sağlar.
Daha Güvenilir Modeller
Üretim öncesinde tespit edilen risklerin azaltılmasına yardımcı olur.
Guardrails'i Güçlendirir
Testlerde ortaya çıkan yeni saldırı yöntemleri, güvenlik mekanizmalarının geliştirilmesine katkı sağlar.
Kullanıcı Güvenini Artırır
Daha kapsamlı testlerden geçen sistemlerin güvenilirliği artırılabilir.
Karşılaşılan Zorluklar
Sonsuz Saldırı Senaryosu
Tüm olası saldırı biçimlerini önceden tahmin etmek mümkün değildir.
Sürekli Güncelleme
Yeni saldırı teknikleri ortaya çıktıkça test senaryolarının da güncellenmesi gerekir.
İnsan Kaynağı
Özellikle karmaşık güvenlik açıklarının bulunması deneyimli uzmanlar gerektirebilir.
Otomasyon
Otomatik testler geniş kapsam sağlayabilir ancak bazı senaryoların değerlendirilmesi hâlâ insan uzmanlığı gerektirebilir.
Red Teaming ile AI Evals Arasındaki Fark
AI Evals
Modelin belirli görevlerdeki performansını, doğruluğunu veya güvenlik ölçütlerini sistematik olarak değerlendirmeye odaklanır.
Red Teaming
Modeli kasıtlı olarak zorlayarak güvenlik açıklarını, beklenmeyen davranışları ve saldırıya karşı zayıflıkları araştırır.
İki yaklaşım birbirinin alternatifi değildir. Birlikte kullanıldıklarında daha kapsamlı bir değerlendirme süreci oluşturabilirler.
Red Teaming ile Penetrasyon Testi Arasındaki Fark
Penetrasyon Testi
Bilgisayar sistemleri, ağlar, uygulamalar ve altyapılardaki güvenlik açıklarını bulmaya yönelik kontrollü güvenlik testidir.
Red Teaming
Yapay zekâ sistemlerinin davranışlarını, güvenlik sınırlarını ve kötüye kullanım risklerini test etmeye odaklanır.
İki yaklaşım farklı hedeflere sahip olsa da kontrollü saldırı senaryoları kullanmaları bakımından benzerlik gösterir.
Gelecekte Red Teaming
Yapay zekâ sistemleri daha fazla araç ve harici veri kaynağıyla çalıştıkça Red Teaming'in kapsamının da genişlemesi beklenmektedir.
Özellikle;
- AI Agent sistemlerine yönelik yeni saldırı senaryoları,
- Otomatik Red Teaming araçları,
- Metin, görsel ve ses tabanlı saldırı testleri,
- AI Guardrails ile entegre güvenlik testleri,
- Sürekli güvenlik değerlendirme sistemleri
önem kazanmaya devam edecektir.
Sık Sorulan Sorular
Red Teaming nedir?
Yapay zekâ modellerinin güvenlik açıklarını ve beklenmeyen davranışlarını ortaya çıkarmak amacıyla yapılan kontrollü saldırı ve stres testi sürecidir.
Red Teaming neden önemlidir?
Model üretime alınmadan önce güvenlik risklerinin belirlenmesine ve azaltılmasına yardımcı olur.
AI Evals ile aynı mı?
Hayır. AI Evals modelin belirli ölçütlerdeki performansını değerlendirirken, Red Teaming özellikle güvenlik açıklarını ve kötüye kullanım senaryolarını araştırır.
Red Teaming yalnızca LLM'lerde mi kullanılır?
Hayır. AI Agent, multimodal AI, RAG ve araç kullanan diğer yapay zekâ sistemleri de Red Teaming kapsamında test edilebilir.
Gelecekte daha yaygın olacak mı?
Evet. Özellikle AI Agent ve kurumsal yapay zekâ sistemlerinin yaygınlaşmasıyla Red Teaming süreçlerinin daha önemli ve sistematik hâle gelmesi beklenmektedir.
Kaynaklar
OpenAI – Safety & Red Teaming Research, Anthropic – Responsible Scaling Policy, Google DeepMind – Frontier Safety Framework, Microsoft – AI Red Team Documentation, IEEE Xplore Digital Library, arXiv – Red Teaming Large Language Models: A Survey
Editör Notu
Bu içerik Bitcanli Editörü tarafından hazırlanmıştır. İçerikte yer alan bilgiler yalnızca bilgilendirme amacı taşımaktadır. Red Teaming ve yapay zekâ güvenlik testleri hızla gelişmektedir. Güncel akademik araştırmaların, teknik raporların ve açık kaynak projelerin düzenli olarak takip edilmesi önerilmektedir.






Bunlar da ilginizi çekebilir
-i6a7b8e2f41de7-700x394.png)
Yapay Zekâ Şirketleri Kendi İnternetini Kuruyor: AI Trafiği Neden Bu Kadar Büyüdü?
Yapay zekâ sistemleri büyüdükçe binlerce GPU arasında taşınan veri de artıyor. AI networking teknolojileri, teknoloji şirketlerinin veri merkezi altyapısını yeniden şekillendiriyor.
1 ay önce
Inference Labs Nedir? Doğrulanabilir Yapay Zekâ (Verifiable AI) Altyapısı Nasıl Çalışır?
Yapay zekâ bir sonuç ürettiğinde ona neden güvenelim? Inference Labs, AI çıktılarının gerçekten nasıl üretildiğini kriptografik kanıtlarla doğrulamayı amaçlıyor.
1 ay önce
Atoma Network Nedir? Merkeziyetsiz Yapay Zekâ Çıkarım (AI Inference) Ağı Nasıl Çalışır?
Yapay zekâ çalışırken verileriniz ve modelin kendisi gerçekten güvende mi? Atoma, AI çıkarımını merkeziyetsiz altyapı, doğrulanabilir hesaplama ve gizli işlem teknolojileriyle yeniden ele alıyor.
1 ay önce