
-i6a77249e192b0.png)

RLAIF Nedir? Yapay Zekâ Başka Bir Yapay Zekâdan Geri Bildirim Alarak Nasıl Öğreniyor?
RLAIF, yapay zekâ modellerinin insan yerine başka yapay zekâ sistemlerinden aldığı geri bildirimlerle eğitilmesini sağlayarak model geliştirme sürecini daha hızlı ve ölçeklenebilir hâle getirmeyi amaçlıyor.
23/08/2026 14:07 | Son Güncelleme : 16/09/2026 18:55 | Netosfer
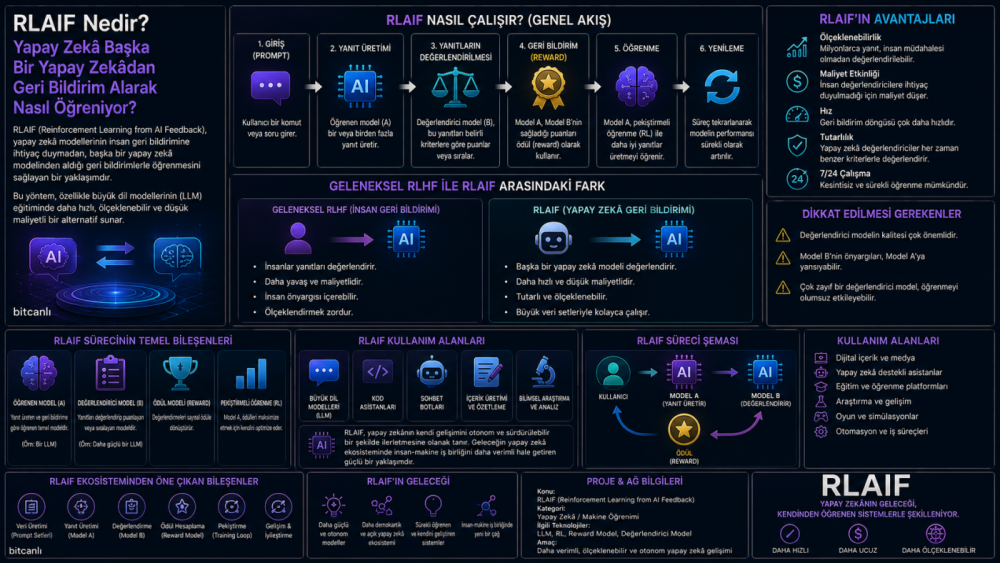
Büyük dil modellerinin geliştirilmesinde uzun yıllardır RLHF (Reinforcement Learning from Human Feedback) yöntemi kullanılıyor. Ancak milyonlarca kaliteli insan değerlendirmesi toplamak hem maliyetli hem de zaman alıcı olabiliyor.
Bu noktada RLAIF (Reinforcement Learning from AI Feedback), geri bildirim sürecinin bir bölümünü başka yapay zekâ modellerine devrederek daha ölçeklenebilir bir eğitim yaklaşımı sunuyor. Böylece bir yapay zekâ modeli, başka bir yapay zekânın değerlendirmelerinden yararlanarak yanıtlarını geliştirebiliyor.
RLAIF özellikle AI Alignment çalışmalarında, yapay zekâ sistemlerinin belirlenen davranış kurallarına daha iyi uyum sağlaması amacıyla kullanılan yöntemlerden biri hâline geldi.
RLAIF Nedir?
RLAIF (Reinforcement Learning from AI Feedback), yapay zekâ modellerinin insanların doğrudan verdiği geri bildirimler yerine başka bir yapay zekâ modelinin ürettiği değerlendirmelerden yararlanılarak hizalanmasını amaçlayan eğitim yaklaşımıdır.
Bu yaklaşım sayesinde:
- İnsan değerlendirmesine duyulan ihtiyaç azaltılabilir.
- Büyük miktarda veri daha hızlı değerlendirilebilir.
- Eğitim süreçleri daha kolay ölçeklenebilir.
- Model davranışları belirlenen kriterlere göre optimize edilebilir.
Buradaki temel fikir oldukça basittir: Bir yapay zekâ modeli cevap üretirken, başka bir yapay zekâ modeli bu cevapların kalitesini değerlendirebilir.
RLAIF Nasıl Çalışır?
RLAIF süreci kullanılan eğitim yöntemine göre değişebilse de temel mantık birkaç aşamadan oluşur.
1. Model Cevap Üretir
Eğitilen model aynı soruya birden fazla yanıt oluşturabilir.
Örneğin bir kullanıcı sorusuna iki farklı cevap üretildiğini düşünelim.
2. AI Değerlendirici Devreye Girer
Daha güçlü veya özel olarak yapılandırılmış bir yapay zekâ modeli, oluşturulan cevapları belirlenen kriterlere göre değerlendirir.
Değerlendirme; doğruluk, faydalılık, güvenlik veya belirli davranış kurallarına uygunluk gibi ölçütlere dayanabilir.
3. Tercih Verisi Oluşturulur
AI değerlendirici, cevaplardan hangisinin daha iyi olduğunu belirleyebilir.
Böylece eğitim sürecinde kullanılabilecek tercih verisi (preference data) oluşturulur.
4. Model Optimize Edilir
Oluşturulan geri bildirim, reward model veya doğrudan tercih optimizasyonu gibi farklı yöntemlerle ana modelin geliştirilmesinde kullanılabilir.
5. Eğitim Tekrarlanır
Bu süreç çok sayıda örnek üzerinde tekrarlandığında modelin hedeflenen davranışları daha iyi öğrenmesi amaçlanır.
RLAIF Neden Önemlidir?
RLHF yönteminde insanların büyük miktarda veriyi inceleyerek cevapları değerlendirmesi gerekebilir. Bu süreç özellikle büyük modellerde ciddi kaynak gerektirebilir.
RLAIF ise değerlendirme sürecinin önemli bir bölümünü yapay zekâya aktararak farklı avantajlar sunabilir:
- Daha düşük değerlendirme maliyeti,
- Daha hızlı veri işleme,
- Daha kolay ölçeklenebilirlik,
- Daha hızlı eğitim iterasyonları.
Ancak bu durum, insan geri bildirimine artık ihtiyaç olmadığı anlamına gelmez. AI değerlendiricilerin kalitesi ve hangi kriterlere göre değerlendirme yaptıkları son derece önemlidir.
RLAIF'in Temel Bileşenleri
Policy Model
Eğitilen ve davranışları geliştirilmeye çalışılan ana yapay zekâ modelidir.
AI Judge
Model tarafından üretilen cevapları değerlendiren yapay zekâ sistemidir.
Preference Data
Hangi cevapların diğerlerinden daha iyi olduğuna ilişkin tercih verileridir.
Reward Model
Bazı RLAIF sistemlerinde AI geri bildirimlerinden öğrenerek model çıktılarının kalitesini değerlendirmeye yardımcı olan modeldir.
Reinforcement Learning
Modelin hedeflenen davranışlara yönelmesini sağlamak için kullanılabilen optimizasyon yaklaşımıdır.
RLAIF Nerelerde Kullanılıyor?
RLAIF özellikle büyük yapay zekâ modellerinin hizalanması ve davranışlarının geliştirilmesi üzerine yapılan çalışmalarda kullanılmaktadır.
Başlıca kullanım alanları:
- Büyük dil modelleri (LLM),
- AI Alignment,
- Constitutional AI,
- AI Agent sistemleri,
- Kod üreten yapay zekâ modelleri,
- Kurumsal yapay zekâ sistemleri,
- Eğitim amaçlı AI modelleri.
Özellikle çok büyük veri kümelerinin değerlendirilmesi gereken durumlarda AI tabanlı geri bildirim mekanizmaları önemli avantaj sağlayabilir.
RLAIF'in Avantajları
Daha düşük maliyet
İnsan değerlendiricilerin yaptığı işin bir bölümü yapay zekâ tarafından gerçekleştirilebilir.
Daha hızlı değerlendirme
AI modelleri çok büyük miktarda çıktıyı kısa sürede değerlendirebilir.
Ölçeklenebilirlik
Milyonlarca örneğin değerlendirilmesi insan gücüne kıyasla daha kolay ölçeklenebilir.
Tutarlı değerlendirme
Aynı değerlendirme kriterleri doğru şekilde uygulandığında daha standart bir geri bildirim süreci oluşturulabilir.
Hızlı model geliştirme
Geri bildirim döngüsünün hızlanması, model geliştirme süreçlerinin daha hızlı tekrarlanmasına yardımcı olabilir.
RLAIF'in Riskleri ve Zorlukları
RLAIF'in en önemli sorunlarından biri, AI değerlendiricinin hatalarının yeni modele aktarılabilmesidir.
Başlıca zorluklar şunlardır:
- AI değerlendiricinin yanlı olması,
- Yanlış değerlendirmelerin eğitim verisine dönüşmesi,
- Modelin değerlendiricinin davranışlarını aşırı şekilde optimize etmesi,
- İnsan değerlerinin AI tarafından eksik temsil edilmesi,
- Değerlendirme kriterlerinin hatalı belirlenmesi.
Bu nedenle yalnızca AI geri bildirimine güvenmek yerine insan denetimi, kalite kontrolü ve farklı değerlendirme yöntemlerinin birlikte kullanılması önemli olabilir.
RLAIF ile RLHF Arasındaki Fark
RLHF, model çıktılarının insanlar tarafından değerlendirilmesine dayanır.
RLAIF ise bu değerlendirme sürecinde yapay zekâ tarafından üretilen geri bildirimlerden yararlanır.
Temel fark geri bildirimin kaynağıdır:
- RLHF: İnsan geri bildirimi
- RLAIF: Yapay zekâ geri bildirimi
Her iki yöntem de modelin daha faydalı, güvenli ve hedeflenen davranışlara uygun çıktılar üretmesini sağlamayı amaçlar.
RLAIF ile Constitutional AI Arasındaki Fark
Constitutional AI, yapay zekâ modellerinin belirli ilke ve kurallar doğrultusunda kendi çıktılarını değerlendirmesini ve değiştirmesini amaçlayan bir yaklaşımdır.
RLAIF ise yapay zekâ geri bildiriminden yararlanan daha genel bir eğitim yaklaşımıdır.
Bu nedenle Constitutional AI, AI geri bildiriminin kullanıldığı önemli uygulama örneklerinden biri olarak değerlendirilebilir. Ancak iki kavram tamamen aynı değildir.
RLAIF'in Geleceği
RLAIF'in geleceği büyük ölçüde daha güçlü AI değerlendiricilerin geliştirilmesine ve yapay zekâ modellerinin nasıl hizalanacağına ilişkin araştırmalara bağlı olacaktır.
Önümüzdeki dönemde:
- RLHF ile birlikte hibrit eğitim süreçlerinde,
- AI Alignment araştırmalarında,
- AI Agent sistemlerinin davranış optimizasyonunda,
- Büyük dil modellerinin değerlendirilmesinde,
- Kurumsal yapay zekâ sistemlerinde
daha fazla kullanılması mümkün olabilir.
Bununla birlikte RLAIF'in insan geri bildirimini tamamen ortadan kaldırması yerine, insan ve yapay zekâ değerlendirmelerinin birlikte kullanıldığı hibrit sistemlerin daha yaygın hâle gelmesi beklenebilir.
Sık Sorulan Sorular
RLAIF nedir?
RLAIF, yapay zekâ modellerinin başka bir yapay zekâ tarafından üretilen geri bildirimlerden yararlanılarak hizalanmasını amaçlayan eğitim yaklaşımıdır.
RLAIF neden önemlidir?
İnsan değerlendirmesine olan ihtiyacı azaltarak büyük miktarda verinin daha hızlı ve ölçeklenebilir şekilde değerlendirilmesine yardımcı olabilir.
RLAIF ile RLHF aynı mı?
Hayır. RLHF insan geri bildirimine, RLAIF ise yapay zekâ tarafından oluşturulan geri bildirime dayanır.
RLAIF güvenilir mi?
AI değerlendiricinin kalitesine ve kullanılan değerlendirme kriterlerine bağlıdır. Yanlı veya hatalı bir değerlendirici, eğitim sürecine yanlış geri bildirim aktarabilir.
RLAIF ile Constitutional AI aynı şey mi?
Hayır. Constitutional AI belirli ilkeler ve kurallar üzerinden model davranışını geliştirmeye odaklanırken RLAIF, AI geri bildiriminden yararlanan daha genel bir eğitim yaklaşımıdır.
RLAIF hangi modellerde kullanılabilir?
Başta büyük dil modelleri olmak üzere farklı yapay zekâ sistemlerinin hizalanması ve davranış optimizasyonunda kullanılabilir.
RLAIF insan geri bildirimini tamamen ortadan kaldırır mı?
Gerekli değildir. İnsan değerlendirmesi, AI geri bildirimlerinin kalitesini kontrol etmek ve sistemin insan değerleriyle uyumunu değerlendirmek için kullanılmaya devam edebilir.
RLAIF'in en büyük avantajı nedir?
En önemli avantajlarından biri, büyük miktardaki model çıktısının AI tarafından daha hızlı değerlendirilebilmesidir.
RLAIF'in en büyük riski nedir?
AI değerlendiricinin hatalarının veya yanlılıklarının eğitilen modele aktarılması önemli risklerden biridir.
RLAIF'in temel amacı nedir?
Yapay zekâ modellerini daha faydalı, güvenli ve belirlenen davranış kriterlerine uygun hâle getirmek için AI tarafından üretilen geri bildirimlerden yararlanmaktır.
Kaynaklar
Anthropic – Constitutional AI Research, Google Research – RLAIF vs. RLHF, Proceedings of Machine Learning Research (PMLR), IEEE Xplore Digital Library, arXiv – RLAIF vs. RLHF: Scaling Reinforcement Learning from Human Feedback with AI Feedback, arXiv – HRLAIF: Improvements in Helpfulness and Harmlessness in Open-domain Reinforcement Learning From AI Feedback.
Editör Notu
Bu içerik Bitcanlı Editörü tarafından hazırlanmıştır. İçerikte yer alan bilgiler yalnızca bilgilendirme amacı taşımaktadır. RLAIF (Reinforcement Learning from AI Feedback), yapay zekâ modellerinin AI tarafından üretilen geri bildirimlerle hizalanmasını sağlayan modern eğitim yaklaşımlarından biridir. Güncel akademik araştırmaların, teknik raporların ve açık kaynak çalışmaların takip edilmesi önerilir.






Bunlar da ilginizi çekebilir
-i6a7b8e2f41de7-700x394.png)
Yapay Zekâ Şirketleri Kendi İnternetini Kuruyor: AI Trafiği Neden Bu Kadar Büyüdü?
Yapay zekâ sistemleri büyüdükçe binlerce GPU arasında taşınan veri de artıyor. AI networking teknolojileri, teknoloji şirketlerinin veri merkezi altyapısını yeniden şekillendiriyor.
1 ay önce
Inference Labs Nedir? Doğrulanabilir Yapay Zekâ (Verifiable AI) Altyapısı Nasıl Çalışır?
Yapay zekâ bir sonuç ürettiğinde ona neden güvenelim? Inference Labs, AI çıktılarının gerçekten nasıl üretildiğini kriptografik kanıtlarla doğrulamayı amaçlıyor.
1 ay önce
Atoma Network Nedir? Merkeziyetsiz Yapay Zekâ Çıkarım (AI Inference) Ağı Nasıl Çalışır?
Yapay zekâ çalışırken verileriniz ve modelin kendisi gerçekten güvende mi? Atoma, AI çıkarımını merkeziyetsiz altyapı, doğrulanabilir hesaplama ve gizli işlem teknolojileriyle yeniden ele alıyor.
1 ay önce