
-i6a77249e192b0.png)
Speculative Decoding Nedir? Büyük Dil Modelleri Daha Hızlı Yanıtları Nasıl Üretiyor?
Bir yapay zekâ uygulamasında yanıtın kalitesi kadar, ne kadar hızlı üretildiği de önemlidir. Uzun bir açıklamanın ekrana yavaşça gelmesi, kod tamamlama aracının bekletmesi veya bir yapay zekâ ajanının her adımda uzun süre duraklaması kullanıcı deneyimini etkileyebilir.
10/10/2026 20:45 | Son Güncelleme : 31/10/2026 23:01 | Netosfer
Büyük dil modellerinin bu bekleme süresi oluşumlarından biri, çoğu tokenları sırayla üretebilirler . Her yeni token, süresi boyunca metne bağlıdır. Modelin büyüklüğünün bu üretim adımlarının maliyeti de önemli hale gelebilir.
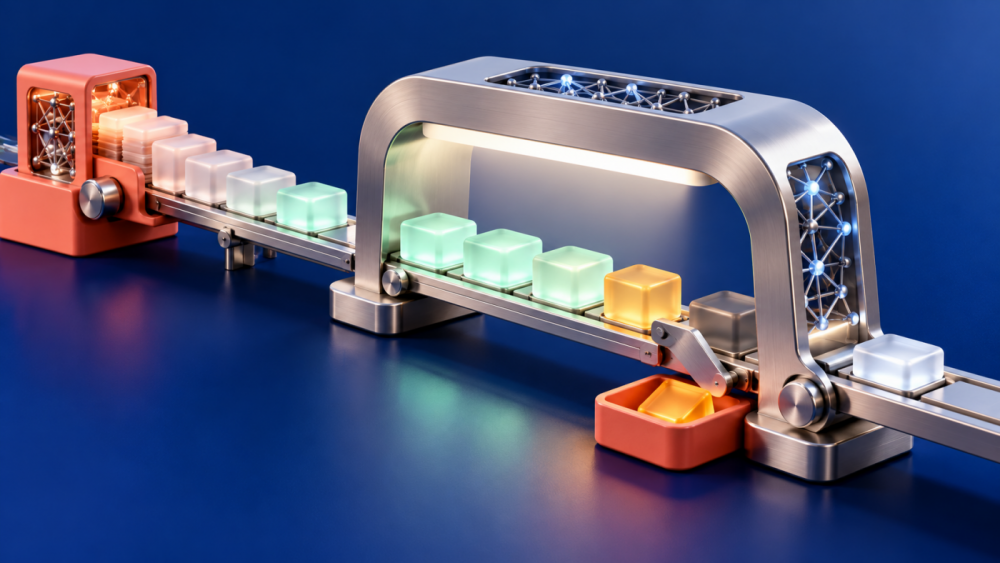
Spekülatif Kod Çözme , büyük modelin kabul edilebilir devamları öncesinde daha düşük maliyetle önererek bu süreci hızlandırmayı amaçlamaktadır. Büyük model, önerilen tokenları topluca değerlendirir ve uygun bulunan başlangıç bölümünü kabul eder.
Yöntemin süresinde, pahalı üretim adımlarını en aza indirmek vardır. Ancak hız kazancı; yardımcı modelin güvenliğine, onarım maliyetine ve kullanılan altyapıya bağlıdır.
Spekülatif Kod Çözme Nedir?
Spekülatif Kod Çözme , günlük token dizilerinin önceden oluşturulup hedef dil modeli tarafından doğrulanmasına dayalı bir çıkarma tekniğidir.
Yaygın olarak kullanılan düzenekte iki model görev alır:
- Taslak model: Birkaç tokenlik günde devamı hızlı şekilde üretilir.
- Hedef model: Adayların değerlendirilmesi ve kabul edilecek devamı belirlenir.
Taslak model, kişiye verilecek cevabın son karar mercii değildir. Görevi, hedef modelin kabul edilebilir tokenları mümkün olduğunca düşük maliyetle önermesidir.
Burada “doğrulama”nın anlamı önemlidir. Hedef model, önerilen çözümün gerçek dünyada doğru olup olmadığını araştırmaz. Tokenlerin kendi üretim kuralları ve olasılıklarıyla uyumu değerlendirilir. Bu nedenle Spekülatif Kod Çözme, yanlış bilgi üretimini ortadan kaldıran bir yöntem değildir.
Token Token Üretimi Neden Yavaşlayabilir?
Token, her zaman bir kelimeye cevap vermez. Bir parça parça, noktalama işareti veya başka bir metin birimi olabilir.
Otoregresif üretimde model, mevcut bağlamaya bakarak sıradaki tokenın olasılıklarını hesaplar. Bir token seçildikten sonra bağlar genişler ve sonraki üretim adımı başlar.
KV Cache dağıtımı önceki belirteçlere göre bazı programlamalar yeniden kullanılabilir. Buna göre her yeni üretim adımında modelin katmanları üzerinden programlama yapılması gerekir.
Özellikle düşük eşzamanlılıkla çalışan büyük modellerde, model ağırlıklarının bellekten depolanması önemli bir maliyet sağlar. Spekülatif Kod Çözme, aynı büyük modelin boyutundan daha fazla ilerlemeye çalışır.
Spekülatif Kod Çözme Nasıl Çalışılır?
Sistem önce kullanıcı girişini işler. Ardından taslak model, mevcut bağlamanın devamı için birkaç simge önerir.
Örneğin bir gün devamı şöyle olabilir:
“Bu yöntemin temel avantajı…”
Hedef model, önerilen diziyi topluca değerlendirerek her konumdaki jeton olasılıklarını hesaplar. Aday tokenlar hazır olduğu için bu şekilde saklanabilir, uygun dikkat maskesiyle tek bir ileri geçiş içinde gerçekleştirilebilir.
Sürecin devam etmesi özetlenebilir:
- Aday üretimi: Taslak model birkaç tokenlik devam etmeyi önerir.
- Toplu değerlendirme: Hedef model önerilen diziyi işler.
- Kabul kontrolü: Tokenlar, kullanılan uygulamaların kabul koşullarına göre kullanılır.
- Kullanım: İlk olarak reddedilen uygun bir token seçilir.
- Yeni tur: Güncellenen bağlama üzerinden günde üretim tekrar başlıyor.
Bir gün reddedildiğinde, onun aktarım önerilerini doğrudan kullanmaz. Çünkü sonraki tokenlar, artık kabul edilmeyen bir devam üzerinden bölümleniyor.
Adayların tamamı kabul edilirse, bazı standart düzenlerde aynı süreklilik turunda hedef modelden ek bir jeton da üretilebilir.
Hedef Model Yalnızca Kontrol mü Yapar?
Hedef modelin rolü “sadece sağlıklı yapar” şeklindeki performansları eksik kalıyor.
Hedef modeli, aday tokenların olasılıklarını hesaplar. Bir adayın düzeltilmesi durumunda düzeltme tokeninin seçilmesine katkı sağlar. Aday dizinin tamamı kabul değişimi de üretimin bir sonraki adımını ilerleyebilir.
Dolayısıyla büyük model devreden çıkarılmaz. Nihai üretim davranışını modellenmeye devam eder; yalnızca çalıştırma biçimi daha verimli hale getirilmeye çalışılır.
Aynı Yanıt mı, Aynı Dağılım mı Korunuyor?
“Kalite değişmeden hızlanır” verinin geliştirilmesi için üretim süreçlerinin ayrılması gerekir.
Açgözlü kod çözme , modelin dayanıklılığı ve yüksek olasılıklı belirteci seçer. Uygun frekans aralığıyla, doğrudan hedef modelin üretebileceği token dizisi korunabilir.
Olasılıksal el becerisinde ise tokenlar belirli bir dağılımdan seçilir. Dağılımı koruyan spekülatif örnekleme geliştirmeleri, kabul ve iyileştirme süreçleri hedef modelin kişisel gelişimlerini ayrıntılı şekilde tasarlar.
Bu, ayrı cihazlarda mutlaka aynı cümlenin üretileceği anlamına gelmez. Rastgele elleçleme zaten farklı tepkiler verir.
Önemli olan, doğru algoritma ve uyumlu örnekleme koşullarında küçük modelin hedef modelin çıktı dağılımını değiştirmemesidir. Her spekülatif üretim varyantının bu güvenceyi aynı biçimde sunduğu varsayılmamalıdır.
Hız Kazancını Belirleyen Etkenler
Draft modelin küçük olması tek başına yeterli değildir. Çok hızlı fakat hedef modelle uyumsuz öneriler üreten bir model, sık reddedilen tokenlar nedeniyle sınırlı fayda sağlayabilir.
| Etken | Neden önemli? |
|---|---|
| Aday üretim maliyeti | Yardımcı modelin çalışması toplam süreye eklenir. |
| Kabul oranı | Bir doğrulama turunda ne kadar ilerlenebileceğini belirler. |
| Aday dizi uzunluğu | Daha fazla ilerleme fırsatı sunarken doğrulama yükünü artırabilir. |
| Donanım | Bellek bant genişliği ve hesaplama kapasitesi kazancı etkiler. |
| Eşzamanlı trafik | Tek istek gecikmesi ile toplam servis kapasitesini farklı biçimde etkileyebilir. |
Bu nedenle en uygun yardımcı model, mutlaka en küçük model değildir. Asıl hedef, tahminlerin kabul edilme ihtimali ile onları üretmenin maliyeti arasında denge kurmaktır.
Benzer şekilde, her turda daha fazla token önermek her zaman daha hızlı sonuç vermez. Uzun bir aday dizinin başlarında ret oluşursa sonraki tahminlerin önemli bölümü kullanılamaz.
İlk Yanıt Süresi Her Zaman Kısalır mı?
Speculative Decoding öncelikle cevap üretim aşamasını, yani decoding sürecini hızlandırmayı hedefler.
Uzun bir kullanıcı girdisinin modele işlenmesi ise prefill adı verilen ayrı bir aşamadır. Örneğin yüzlerce sayfalık bir belge gönderildiğinde, ilk tokena kadar geçen sürenin önemli bölümü girişin işlenmesinden kaynaklanabilir.
Bu ayrım nedeniyle yöntem:
- Uzun cevapların tamamlanma süresini azaltabilir.
- Üretim sırasında tokenların daha hızlı gelmesini sağlayabilir.
- İlk token gecikmesini her koşulda azaltmayabilir.
Kısa yanıtlar için yardımcı modelin ek maliyeti daha belirgin olabilir. Uzun üretimlerde ise kabul edilen tokenların sağladığı avantaj daha fazla birikebilir.
Nerelerde Kullanılabilir?
Kod tamamlama sistemlerinde, tekrar eden sözdizimi ve öngörülebilir devamlar aday üretimi için uygun olabilir. Yine de başarı, programlama diline ve görevin karmaşıklığına göre değişir.
Sohbet uygulamalarında, uzun açıklamalar veya ayrıntılı yanıtlar daha kısa sürede tamamlanabilir.
Yapay zekâ ajanlarında, birden fazla model çağrısının toplam süresini azaltmaya katkı sağlayabilir. Ancak iş akışındaki asıl bekleme araç çağrılarından veya ağ işlemlerinden kaynaklanıyorsa, metin üretimini hızlandırmak bütün görevi aynı ölçüde hızlandırmaz.
Kurumsal servislerde, gerçek trafik altında ölçüm yapılması gerekir. Tek kullanıcı için elde edilen hız artışı, yoğun eşzamanlı kullanımda aynı oranda kapasite artışı anlamına gelmeyebilir.
Speculative Decoding ile KV Cache Arasındaki Fark
Bu iki yöntem üretim sürecinin farklı maliyetlerini hedefler.
KV Cache , önceki tokenların anahtar ve değer temsillerini saklayarak bunların tekrar gösterilmelerini korur.
Spekülatif Kod Çözme , belirlenen tokenlar için günlerde oluşturup bunları topluca doğrulayarak büyük modelin üretim turlarını çalıştırılır.
Birlikte kullanılabilirler. Ancak kazançları doğrudan toplanmaz; Bir bilgisayarın performansında sistem darboğazı başka bir taşınabilir.
Ayrı Bir Taslak Model Zorunlu mu?
Hayır. Ayrı bir küçük model, yaygın olarak kullanılan düzenektir; fakat spekülatif üretimin tek biçimi değildir.
Adaylar ek tahmin başlıklarından, modellerin ara temsillerinden veya güvenilir tekrarlayan dizilerden de üretilebilir. Bu yaklaşımların eğitim koşulları ve bellek süreleri farklılık göstermektedir.
Dolayısıyla “Spekülatif Kod Çözme modelinin ağırlığını değiştirmez” ifadesinin kullanım aşaması bakış açısı doğru olsa da bütün yöntemin ailesini açıklamaz. Klasik iki model düzeni hedef model yeniden kullanılandan uygulanabilir; bazı alternatifler ise ek birikimlerin yapılmasını gerektirir.
Sık Sorulan Sorular
Taslak modelin yanlış tahmin edilmesi ne olur?
Önerilen tokenlar doğrudan kullanıcıya gösterilmez. Doğrulama sırasında reddedilen devam ettirilir ve üretim güncellenen bağlama üzerinden devam eder.
Her modelde hız artışı sağlar mı?
Hayır. Kabil oranı düşük veya günlük üretim pahalıysa kazanç azalabilir. Bazı toplam üretim süresi uzayabilir.
Daha fazla bellek mi gerektirir?
Ayrı yardımcı model kullanılan düzenlilerde ek model ağırlıkları ve önbellek için bellek gerekir. Bu nedenle hız kazandırılabilir, bellek ihtiyaçlarıyla birlikte değerlendirilmelidir.
Yanlış bilgi üretimini azaltır mı?
Yöntemin temel amacı üretimi hızlandırmaktır. Hedef modelin kendi bilgi hatalarını veya halüsinasyonlarını otomatik olarak düzeltmez.
Kaynaklar: Yaniv Leviathan, Matan Kalman ve Yossi Matias — Fast Inference from Transformers via Speculative Decoding; Charlie Chen ve diğerleri — Accelerating Large Language Model Decoding with Speculative Sampling.
Editör Notu
Bu içerik, spesifik üretimin çalışma mantığını ve büyük dil modelinin çıkarılmasındaki kullanımı ele alan bir araştırma ve değerlendirme yazısıdır. İçerikte yer alan değerlendirmeler editoryal yorum niteliğindedir. Hız kazancı, belleklerin ve ortaya çıkan durumun ortaya çıkması; Kullanılan yazılıma, günlük üretim yöntemine, kullanım ayarlarına, donanıma ve iş yüküne bağlıdır. Tek bir performans görünümü, bütün uygulamalar için aynı sonucu garanti etmez.
Bunlar da ilginizi çekebilir
-i6a7b8e2f41de7-700x394.png)
Yapay Zekâ Şirketleri Kendi İnternetini Kuruyor: AI Trafiği Neden Bu Kadar Büyüdü?
Yapay zekâ sistemleri büyüdükçe binlerce GPU arasında taşınan veri de artıyor. AI networking teknolojileri, teknoloji şirketlerinin veri merkezi altyapısını yeniden şekillendiriyor.
2 ay önce
Inference Labs Nedir? Doğrulanabilir Yapay Zekâ (Verifiable AI) Altyapısı Nasıl Çalışır?
Yapay zekâ bir sonuç ürettiğinde ona neden güvenelim? Inference Labs, AI çıktılarının gerçekten nasıl üretildiğini kriptografik kanıtlarla doğrulamayı amaçlıyor.
2 ay önce
Atoma Network Nedir? Merkeziyetsiz Yapay Zekâ Çıkarım (AI Inference) Ağı Nasıl Çalışır?
Yapay zekâ çalışırken verileriniz ve modelin kendisi gerçekten güvende mi? Atoma, AI çıkarımını merkeziyetsiz altyapı, doğrulanabilir hesaplama ve gizli işlem teknolojileriyle yeniden ele alıyor.
2 ay önce