-i6a77249e192b0.png)

En güncel haberleri, analizleri ve rehberleri tek bir yerde arayın.
Büyük bir yapay zekâ modelini çalıştırırken karşılaşılan sorun yalnızca işlem gücü değildir. Model ağırlıklarının, ara hesaplamaların ve diğer verilerin belleğe sığması da gerekir. Tek bir GPU’nun hesaplama kapasitesi yeterli görünse bile belleği model için yetersiz kalabilir.
3 hafta önce
Büyük dil modelleri, milyarlarca parametre içerir. Bu parametrelerin bellekte saklanması ve hesaplamalarda kullanılması, özellikle büyük modellerde önemli donanım kaynakları gerektirir.
3 hafta önce
Büyük dil modellerini belirli görevlere uyarlamak, önemli miktarda hesaplama gücü ve bellek gerektirebilir. Özellikle modelin bütün ağırlıklarının güncellendiği tam ince ayar işlemlerinde, ağırlıkların yanında gradyanlar, ara hesaplamalar ve optimizasyon bilgileri de GPU belleğinde yer kaplar.
3 hafta önce
Büyük dil modelleri, milyarlarca parametre sayesinde metin üretme, soruları yanıtlama, kod yazma ve belgeleri yorumlama gibi birçok görevi yerine getirebilir. Ancak genel amaçlı bir modelin belirli bir şirketin iletişim tarzına, sektörün terminolojisine veya özel bir görev biçimine uyarlanması için...
3 hafta önce
Büyük dil modellerinin gelişmesi, yalnızca daha güçlü işlemcilere değil, daha verimli dağıtık hesaplama yöntemlerine de ihtiyaç doğuruyor. Milyarlarca parametreye sahip modellerin ağırlıkları, eğitim sırasında kullanılan ara hesaplamalar ve optimizasyon bilgileri, tek bir GPU’nun belleğini aşabiliyo...
3 hafta önce
Büyük yapay zekâ modellerinin yeteneklerinden yararlanmak, önemli miktarda bellek ve hesaplama kaynağı gerektirebilir. Özellikle cihaz üzerinde çalışan uygulamalarda ve yoğun kullanıcı trafiğine sahip servislerde, modelin doğruluğu kadar çalıştırma maliyeti de önem taşır.
3 hafta önce
Büyük dil modellerinde daha fazla parametre, daha geniş öğrenme kapasitesi sağlayabilir. Ancak modelin büyümesi, hesaplama ve bellek ihtiyacını da artırabilir. Mixture of Experts (MoE), model kapasitesini her token için yapılan hesaplamayla aynı oranda büyütmeden artırmaya yönelik mimari yaklaşımlar...
3 hafta önce
Büyük dil modellerinin kapasitesini artırmak için daha fazla parametre kullanmak mümkündür. Ancak model büyüdükçe hesaplama, bellek ve iletişim maliyetleri de önem kazanır. Araştırmacılar bu nedenle model kapasitesini, her girdide yapılacak hesaplamayı aynı oranda artırmadan büyütmenin yollarını gel...
3 hafta önce
Büyük dil modellerini belirli bir göreve uyarlamak, önemli miktarda bellek ve hesaplama kaynağı gerektirebilir. Tam ince ayar (Full Fine-Tuning) yönteminde önceden eğitilmiş modelin bütün ağırlıkları güncellenir. Model büyüdükçe bu güncellemelerin eğitim ve depolama maliyeti de artabilir.
3 hafta önce
Büyük dil modellerini belirli bir göreve uyarlamak, önemli miktarda hesaplama kaynağı gerektirebilir. Tam ince ayar (Full Fine-Tuning) yönteminde modelin bütün ağırlıkları güncellenir. Milyarlarca parametreye sahip modellerde bu süreç, yüksek bellek tüketimi ve eğitim maliyeti oluşturabilir.
3 hafta önce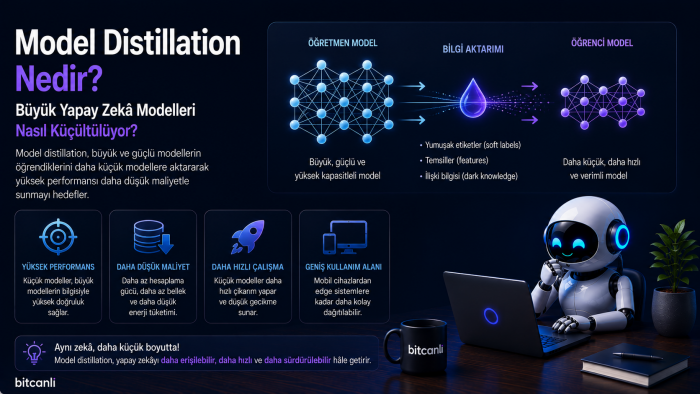
Model Distillation, büyük yapay zekâ modellerinin öğrendiği bilgileri daha küçük modellere aktararak daha hızlı, düşük maliyetli ve düşük donanım gerektiren AI sistemleri geliştirilmesini sağlıyor. Peki Teacher ve Student modelleri arasındaki bu bilgi aktarımı nasıl gerçekleşiyor?
2 ay önce