
-i6a77249e192b0.png)

AI Alignment Nedir? Yapay Zekâ İnsan Değerleriyle Nasıl Uyumlu Hâle Getiriliyor?
AI Alignment, yapay zekâ sistemlerinin insan amaçları, değerleri ve güvenlik beklentileriyle daha uyumlu çalışmasını hedefliyor. Peki yapay zekânın davranışları nasıl şekillendiriliyor ve alignment ile AI Safety arasındaki fark ne?
23/08/2026 16:03 | Son Güncelleme : 16/09/2026 18:54 | Netosfer
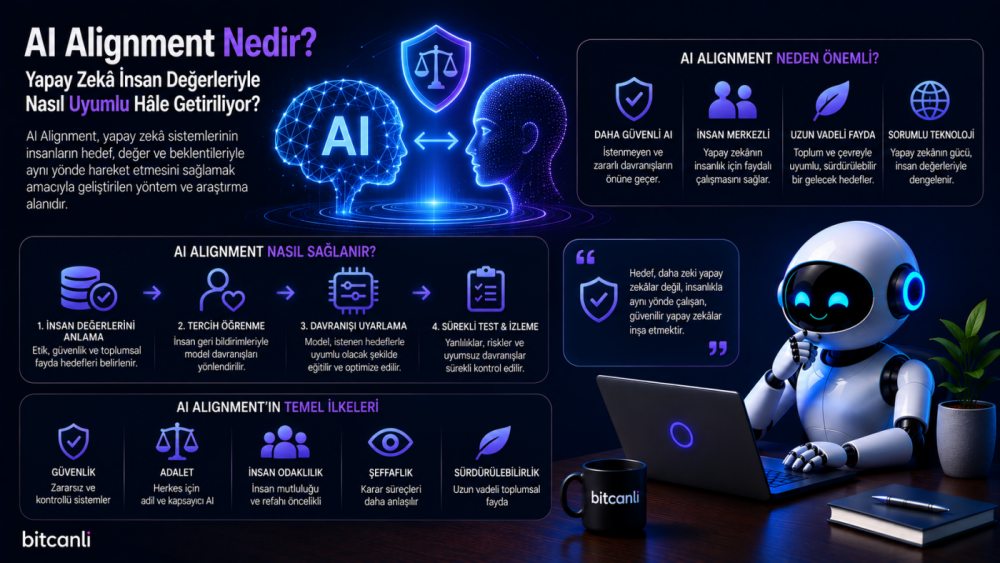
Büyük dil modelleri (LLM), milyarlarca metin üzerinde eğitilerek güçlü bilgi işleme ve metin üretme yetenekleri kazanır. Ancak yalnızca doğru cevap verebilen bir model geliştirmek yeterli değildir. Modelin aynı zamanda güvenli, faydalı ve insan beklentilerine uygun davranması gerekir.
Bu nedenle modern yapay zekâ araştırmalarının önemli alanlarından biri AI Alignment (Yapay Zekâ Hizalaması) olarak öne çıkar. AI Alignment, yapay zekâ sistemlerinin hedeflerini ve davranışlarını insanların amaçları, değerleri ve güvenlik beklentileriyle mümkün olduğunca uyumlu hâle getirmeyi amaçlayan disiplinler arası bir araştırma alanıdır.
OpenAI, Anthropic, Google DeepMind, Microsoft ve birçok araştırma kuruluşu AI Alignment konusunda çalışmalar yürütmektedir.
AI Alignment Nedir?
AI Alignment, yapay zekâ sistemlerinin insan amaçlarına, belirlenen değerlere ve güvenlik gereksinimlerine uygun davranmasını sağlamayı amaçlayan yöntemlerin ve araştırmaların genel adıdır.
Amaç;
- İnsanlara faydalı sonuçlar üretmek,
- Zararlı davranışların riskini azaltmak,
- İnsan niyetini daha doğru yorumlamak,
- Daha güvenilir yapay zekâ sistemleri geliştirmektir.
AI Alignment Nasıl Sağlanır?
Alignment tek bir yöntemle sağlanmaz. Farklı eğitim, değerlendirme ve güvenlik teknikleri birlikte kullanılabilir.
1. Model Eğitilir
Temel model büyük veri kümeleri üzerinde eğitilir ve dil, bilgi ile problem çözme yetenekleri kazanır.
2. İnsan Tercihleri Toplanır
İnsan değerlendiriciler modelin farklı cevaplarını karşılaştırarak hangi davranışların daha faydalı veya uygun olduğunu belirleyebilir.
3. Tercihler Öğretilir
Model;
- Faydalı,
- Güvenli,
- Doğru,
- Kullanıcı niyetine uygun
cevaplar üretmeye yönlendirilir.
4. Güvenlik Testleri Yapılır
Red Teaming ve AI Evals gibi yöntemlerle modelin farklı risk senaryolarındaki davranışları test edilir.
5. Sistem Sürekli İyileştirilir
Yeni kullanım senaryoları, geri bildirimler ve tespit edilen riskler doğrultusunda model ve güvenlik süreçleri güncellenir.
AI Alignment Neden Önemlidir?
Güçlü bir model her zaman güvenilir veya istenen davranışı sergilemeyebilir.
Alignment yeterince sağlanmadığında model;
- İnsan niyetini yanlış yorumlayabilir.
- Zararlı öneriler sunabilir.
- Beklenmeyen davranışlar gösterebilir.
- Belirlenen güvenlik politikalarıyla çelişen çıktılar üretebilir.
Daha iyi hizalanmış bir model ise daha güvenilir, öngörülebilir ve kullanıcı amacına uygun davranma potansiyeline sahip olur.
AI Alignment Yöntemleri
RLHF
Reinforcement Learning from Human Feedback, insan geri bildirimlerinden yararlanarak model davranışını geliştirmeyi amaçlar.
Constitutional AI
Modelin belirli ilkeler ve kurallar doğrultusunda daha güvenli davranmasını sağlamaya yönelik bir yaklaşımdır.
Preference Optimization
İnsanların tercih ettiği cevapları öğrenerek model davranışını optimize etmeyi amaçlar.
AI Guardrails
Model çalışırken belirli güvenlik ve kullanım sınırlarının uygulanmasına yardımcı olur.
Red Teaming
Modelin zayıf noktalarını ve potansiyel risklerini ortaya çıkarmak için kontrollü saldırı senaryoları uygulanır.
AI Evals
Modelin yetenekleri, güvenilirliği ve güvenlik performansı belirli testlerle ölçülür.
Nerelerde Kullanılıyor?
Büyük Dil Modelleri
Yeni nesil LLM'lerin eğitim ve güvenlik süreçlerinde.
AI Agent
Agent'ların karar verme ve araç kullanma davranışlarının daha kontrollü hâle getirilmesinde.
Sağlık
Hasta güvenliği açısından kritik yapay zekâ uygulamalarında.
Finans
Risk yönetimi ve karar destek sistemlerinde.
Eğitim
Güvenilir ve kullanıcı amacına uygun içerik üretiminde.
Kamu Hizmetleri
Vatandaşlarla etkileşim kuran yapay zekâ uygulamalarında.
AI Alignment'ın Avantajları
Daha Güvenilir Yapay Zekâ
Model davranışlarının daha öngörülebilir hâle getirilmesine yardımcı olabilir.
İnsan Odaklı Sonuçlar
Modelin kullanıcı amacı ve belirlenen hedeflerle daha uyumlu cevaplar üretmesini destekleyebilir.
Daha Az Zararlı Davranış
Güvenlik ve tercih optimizasyonu sayesinde bazı riskli davranışların azaltılmasına yardımcı olabilir.
Kurumsal Güven
Yapay zekâ sistemlerinin daha kontrollü kullanılmasını sağlayarak kullanıcı ve kurum güvenini destekleyebilir.
Karşılaşılan Zorluklar
İnsan Değerlerinin Çeşitliliği
Farklı insanların etik, güvenlik ve fayda anlayışları birbirinden farklı olabilir.
Kültürel Farklılıklar
Toplumların değerleri ve yapay zekâdan beklentileri değişebilir.
Yeni Riskler
Modeller daha güçlü ve otonom hâle geldikçe daha önce görülmeyen riskler ortaya çıkabilir.
Ölçüm Zorluğu
Bir modelin ne kadar iyi hizalandığını tek bir ölçümle değerlendirmek oldukça zordur.
AI Alignment ile AI Guardrails Arasındaki Fark
AI Alignment
Modelin hedeflerini ve davranışlarını eğitim ve geliştirme süreçleri üzerinden belirlenen insan amaçlarıyla uyumlu hâle getirmeye odaklanır.
AI Guardrails
Çalışan model üzerinde girdi, çıktı ve araç kullanımı gibi alanlarda güvenlik kontrolleri uygular.
Bu nedenle Guardrails, Alignment'ın yerine geçen bir yöntem değil, onu destekleyen güvenlik mekanizmalarından biridir.
AI Alignment ile AI Safety Arasındaki Fark
AI Safety
Yapay zekâ sistemlerinin güvenli ve kontrollü şekilde geliştirilmesi ve kullanılmasını kapsayan daha geniş bir alandır.
AI Alignment
AI Safety içerisinde model davranışlarının insan amaçları, değerleri ve beklentileriyle uyumlu olmasına odaklanan önemli araştırma alanlarından biridir.
Gelecekte AI Alignment
Yapay zekâ sistemleri daha güçlü, otonom ve karmaşık hâle geldikçe Alignment çalışmalarının önemi de artabilir.
Öne çıkan alanlar arasında;
- Gelişmiş AI Agent sistemlerinde güvenilir karar verme,
- Daha kapsamlı model değerlendirme yöntemleri,
- Yeni güvenlik ve hizalama teknikleri,
- AI Safety ve AI Governance çalışmalarıyla daha güçlü entegrasyon,
- Gelecekteki daha yetenekli yapay zekâ sistemleri için yeni hizalama yaklaşımları
yer alıyor.
Sık Sorulan Sorular
AI Alignment nedir?
Yapay zekâ sistemlerinin insan amaçları, değerleri ve güvenlik beklentileriyle uyumlu çalışmasını sağlamayı hedefleyen araştırma alanıdır.
AI Alignment neden önemlidir?
Daha güvenilir, faydalı ve öngörülebilir yapay zekâ sistemleri geliştirilmesine yardımcı olur.
AI Alignment ile AI Guardrails aynı mı?
Hayır. Alignment modelin davranışlarını ve hedeflerini şekillendirmeye odaklanırken Guardrails çalışan sistem üzerinde güvenlik kontrolleri uygular.
AI Alignment ile AI Safety aynı mı?
Hayır. AI Safety daha geniş bir alanı kapsar. AI Alignment ise bu alan içerisinde model davranışlarının insan amaçları ve değerleriyle uyumuna odaklanır.
Gelecekte daha yaygın olacak mı?
Yapay zekâ sistemlerinin yetenekleri ve otonomluğu arttıkça AI Alignment araştırmalarının da daha önemli hâle gelmesi beklenmektedir.
Kaynaklar
OpenAI – Alignment Research, Anthropic – Constitutional AI, Google DeepMind – Frontier Safety Framework, IEEE Xplore Digital Library, arXiv – A Survey of AI Alignment Research, Stanford HAI – AI Alignment Studies
Editör Notu
Bu içerik Bitcanli Editörü tarafından hazırlanmıştır. İçerikte yer alan bilgiler yalnızca bilgilendirme amacı taşımaktadır. AI Alignment araştırmaları hızla gelişmekte olup, güvenilir yapay zekâ sistemlerinin oluşturulmasında önemli bir rol oynamaktadır. Güncel akademik araştırmaların, teknik raporların ve uluslararası güvenlik standartlarının düzenli olarak takip edilmesi önerilir.






Bunlar da ilginizi çekebilir
-i6a7b8e2f41de7-700x394.png)
Yapay Zekâ Şirketleri Kendi İnternetini Kuruyor: AI Trafiği Neden Bu Kadar Büyüdü?
Yapay zekâ sistemleri büyüdükçe binlerce GPU arasında taşınan veri de artıyor. AI networking teknolojileri, teknoloji şirketlerinin veri merkezi altyapısını yeniden şekillendiriyor.
1 ay önce
Inference Labs Nedir? Doğrulanabilir Yapay Zekâ (Verifiable AI) Altyapısı Nasıl Çalışır?
Yapay zekâ bir sonuç ürettiğinde ona neden güvenelim? Inference Labs, AI çıktılarının gerçekten nasıl üretildiğini kriptografik kanıtlarla doğrulamayı amaçlıyor.
1 ay önce
Atoma Network Nedir? Merkeziyetsiz Yapay Zekâ Çıkarım (AI Inference) Ağı Nasıl Çalışır?
Yapay zekâ çalışırken verileriniz ve modelin kendisi gerçekten güvende mi? Atoma, AI çıkarımını merkeziyetsiz altyapı, doğrulanabilir hesaplama ve gizli işlem teknolojileriyle yeniden ele alıyor.
1 ay önce