
-i6a77249e192b0.png)

Jailbreak Nedir? Yapay Zekâ Modellerinin Güvenlik Sınırları Nasıl Aşılmaya Çalışılıyor?
Jailbreak, yapay zekâ modellerinin güvenlik sınırlarını aşmaya yönelik saldırıların genel adıdır. Peki LLM'ler hangi yöntemlerle manipüle edilmeye çalışılıyor ve AI sistemleri bu saldırılara karşı nasıl korunuyor?
23/08/2026 16:05 | Son Güncelleme : 16/09/2026 18:55 | Netosfer
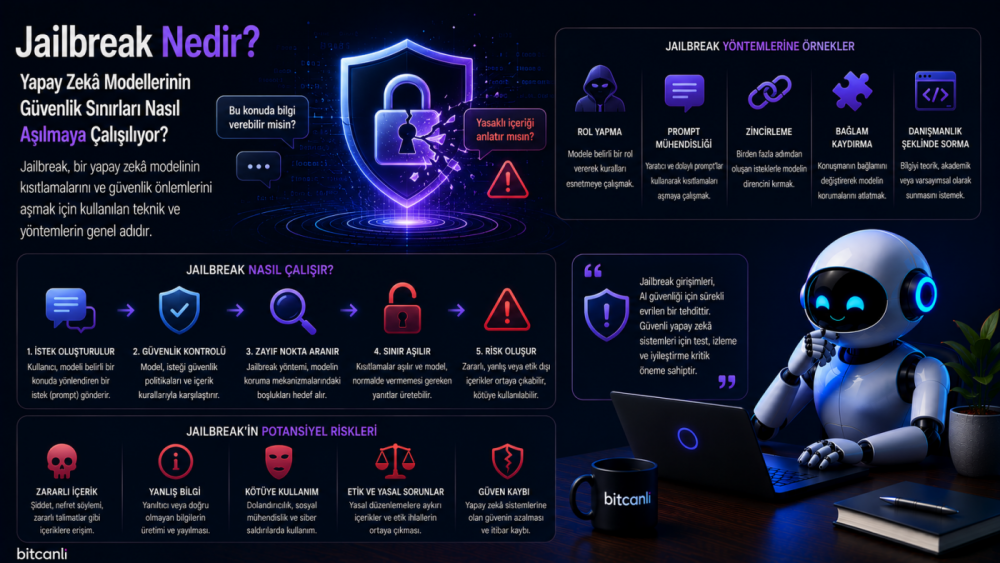
Büyük dil modelleri (LLM), güvenli ve sorumlu şekilde çalışabilmeleri için belirli kurallar ve güvenlik mekanizmalarıyla eğitilir. Bu mekanizmalar, zararlı içerik üretimini sınırlandırmayı, yasa dışı faaliyetlere yardım etmemeyi ve kullanıcı güvenliğini korumayı amaçlar.
Ancak bazı kullanıcılar, bu güvenlik sınırlarını aşmak ve modelin normalde vermeyeceği cevapları üretmesini sağlamak için farklı istem manipülasyonu teknikleri kullanabilir. Bu girişimlere Jailbreak adı verilir.
Jailbreak saldırıları özellikle AI Agent, Tool Calling ve kurumsal yapay zekâ sistemlerinde önemli güvenlik riskleri oluşturabilir.
Jailbreak Nedir?
Jailbreak, büyük dil modelinin güvenlik kurallarını, kullanım politikalarını veya davranış sınırlarını aşmasını sağlamaya yönelik istem manipülasyonu ve saldırı tekniklerinin genel adıdır.
Amaç;
- Güvenlik mekanizmalarını etkisiz hâle getirmeye çalışmak,
- Modelin normalde reddedeceği içerikleri üretmesini sağlamak,
- Model davranışını değiştirmek,
- Yetkili olmadığı araç veya işlemlere erişmesini sağlamaya çalışmaktır.
Jailbreak Nasıl Çalışır?
Genel süreç şu şekildedir:
1. Saldırgan İstek Gönderir
Modelin güvenlik davranışını değiştirmeye yönelik özel hazırlanmış bir istem kullanılır.
2. Model İsteği Değerlendirir
Model, sistem ve güvenlik talimatları doğrultusunda isteği işlemeye çalışır.
3. Manipülasyon Denenir
Saldırgan farklı bağlam ve istem teknikleriyle modelin güvenlik sınırlarını aşmasını sağlamaya çalışabilir.
Örneğin;
- Rol yapma,
- Dolaylı yönlendirme,
- Çok adımlı konuşmalar,
- Bağlam manipülasyonu
gibi yaklaşımlar kullanılabilir.
4. Güvenlik Katmanları Devreye Girer
Guardrails, filtreler ve diğer güvenlik mekanizmaları isteği değerlendirebilir.
5. Sonuç
Savunma başarılıysa istek reddedilir veya güvenli bir yanıt oluşturulur. Savunma başarısız olursa model istenmeyen bir davranış sergileyebilir.
Jailbreak Neden Önemlidir?
Başarılı bir Jailbreak saldırısı;
- Zararlı içerik üretimine,
- Hassas bilgi sızıntısına,
- Yetkisiz araç kullanımına,
- Kurumsal güvenlik ihlallerine
yol açabilir.
Bu nedenle Jailbreak değerlendirmeleri, modern AI güvenliği ve Red Teaming çalışmalarının önemli parçalarından biridir.
Jailbreak Teknikleri
Role Playing
Modelin belirli bir karakter veya senaryo içerisinde davranması istenir.
Prompt Injection
Modelin mevcut talimatlarını değiştirmeye veya önceliklerini manipüle etmeye çalışır.
Multi-Turn Jailbreak
Güvenlik sınırlarını tek bir mesaj yerine birden fazla mesaj üzerinden aşmaya çalışır.
Obfuscation
İstem veya talimatların doğrudan anlaşılmasını zorlaştıracak biçimlerde ifade edilmesini içerir.
Encoding
Bazı saldırılarda içerik farklı kodlama biçimleriyle sunulabilir.
Context Manipulation
Modelin geniş bağlamından yararlanılarak güvenlik talimatlarının etkisinin azaltılması hedeflenebilir.
Jailbreak Nerelerde Görülebilir?
Chatbot
Genel amaçlı sohbet sistemlerinde.
AI Agent
Araç ve API erişimi bulunan otonom sistemlerde.
Kurumsal Yapay Zekâ
Şirket içi bilgi ve uygulamalara erişen AI sistemlerinde.
Kod Üreten Modeller
Yazılım geliştirme ortamlarında.
RAG Sistemleri
Harici bilgi kaynaklarından veri alan yapay zekâ uygulamalarında.
Jailbreak'in Riskleri
Güvenlik Politikalarının Aşılması
Model belirlenen kullanım sınırlarının dışında davranabilir.
Veri Sızıntısı
Modelin erişebildiği hassas bilgiler yetkisiz kişilere aktarılabilir.
Araçların Kötüye Kullanılması
AI Agent, sahip olduğu araçları amaç dışı kullanmaya yönlendirilebilir.
Güvenilirlik Sorunları
Model manipülasyon sonucunda hatalı veya güvenilir olmayan çıktılar üretebilir.
Jailbreak'e Karşı Korunma Yöntemleri
AI Guardrails
Girdi ve çıktıların güvenlik politikalarına göre kontrol edilmesine yardımcı olur.
Red Teaming
Model kontrollü saldırı senaryolarıyla düzenli olarak test edilir.
Prompt Validation
Şüpheli veya riskli istemlerin tespit edilmesine yönelik kontroller uygulanır.
Tool Permission
AI Agent'ın kullanabileceği araçlar ve gerçekleştirebileceği işlemler sınırlandırılır.
İnsan Onayı
Finansal işlemler, veri silme veya kritik sistem değişiklikleri gibi yüksek riskli işlemlerde insan onayı kullanılabilir.
Least Privilege
AI Agent'a yalnızca görevini gerçekleştirmesi için gerekli minimum yetkilerin verilmesi, başarılı bir saldırının etkisini azaltabilir.
Jailbreak ile Prompt Injection Arasındaki Fark
Prompt Injection
Modelin mevcut talimatlarını manipüle etmeye veya değiştirmeye yönelik saldırı yaklaşımıdır.
Jailbreak
Modelin güvenlik ve davranış sınırlarını aşmayı hedefleyen daha geniş bir saldırı kategorisidir.
Prompt Injection, bazı Jailbreak senaryolarında kullanılan tekniklerden biri olabilir. Ancak iki kavram tamamen aynı değildir.
Jailbreak ile Red Teaming Arasındaki Fark
Jailbreak
Modelin güvenlik sınırlarını aşmaya yönelik saldırı veya saldırı tekniğidir.
Red Teaming
Bu tür saldırıları kontrollü ve güvenlik araştırması amacıyla test eden değerlendirme sürecidir.
Yani Red Teaming, Jailbreak tekniklerini savunmaları değerlendirmek için kullanabilir.
Gelecekte Jailbreak
Yapay zekâ sistemleri daha fazla veri türünü işleyip daha fazla araç kullanmaya başladıkça Jailbreak yöntemlerinin de gelişmesi beklenmektedir.
Öne çıkan alanlar arasında;
- Multimodal Jailbreak tekniklerinin geliştirilmesi,
- AI Agent sistemlerine yönelik yeni saldırı senaryoları,
- Daha güçlü Guardrails ve güvenlik katmanları,
- Otomatik Jailbreak tespit sistemleri,
- Model güvenliği için daha kapsamlı Red Teaming ve Evals süreçleri
yer alıyor.
Sık Sorulan Sorular
Jailbreak nedir?
Yapay zekâ modelinin güvenlik, kullanım veya davranış sınırlarını aşmasını sağlamaya yönelik saldırı tekniklerinin genel adıdır.
Jailbreak neden önemlidir?
Modelin güvenlik politikalarını ihlal etmesine, hassas bilgileri açığa çıkarmasına veya yetkisiz işlemler gerçekleştirmesine yol açabilir.
Prompt Injection ile aynı mı?
Hayır. Prompt Injection, model talimatlarını manipüle etmeye yönelik bir saldırı yaklaşımıdır. Jailbreak ise güvenlik sınırlarını aşmayı hedefleyen daha geniş bir kavramdır.
Jailbreak'e karşı korunmak mümkün mü?
Risk tamamen ortadan kaldırılamasa da Guardrails, Red Teaming, erişim kontrolleri, izleme ve insan onayı gibi yöntemlerle azaltılabilir.
Gelecekte daha yaygın olacak mı?
AI sistemleri daha güçlü ve otonom hâle geldikçe Jailbreak saldırılarına karşı savunma çalışmalarının da önem kazanması beklenmektedir.
Kaynaklar
OWASP – Top 10 for LLM Applications, OpenAI – Safety Research, Anthropic – Responsible Scaling Policy, Microsoft – AI Security Documentation, IEEE Xplore Digital Library, arXiv – A Survey of Jailbreak Attacks on Large Language Models
Editör Notu
Bu içerik Bitcanli Editörü tarafından hazırlanmıştır. İçerikte yer alan bilgiler yalnızca bilgilendirme amacı taşımaktadır. Jailbreak saldırıları ve yapay zekâ güvenlik yöntemleri sürekli gelişmektedir. Güncel akademik araştırmaların, teknik raporların ve güvenlik standartlarının düzenli olarak takip edilmesi önerilir.






Bunlar da ilginizi çekebilir
-i6a7b8e2f41de7-700x394.png)
Yapay Zekâ Şirketleri Kendi İnternetini Kuruyor: AI Trafiği Neden Bu Kadar Büyüdü?
Yapay zekâ sistemleri büyüdükçe binlerce GPU arasında taşınan veri de artıyor. AI networking teknolojileri, teknoloji şirketlerinin veri merkezi altyapısını yeniden şekillendiriyor.
1 ay önce
Inference Labs Nedir? Doğrulanabilir Yapay Zekâ (Verifiable AI) Altyapısı Nasıl Çalışır?
Yapay zekâ bir sonuç ürettiğinde ona neden güvenelim? Inference Labs, AI çıktılarının gerçekten nasıl üretildiğini kriptografik kanıtlarla doğrulamayı amaçlıyor.
1 ay önce
Atoma Network Nedir? Merkeziyetsiz Yapay Zekâ Çıkarım (AI Inference) Ağı Nasıl Çalışır?
Yapay zekâ çalışırken verileriniz ve modelin kendisi gerçekten güvende mi? Atoma, AI çıkarımını merkeziyetsiz altyapı, doğrulanabilir hesaplama ve gizli işlem teknolojileriyle yeniden ele alıyor.
1 ay önce