
-i6a77249e192b0.png)

DPO Nedir? Direct Preference Optimization ile Yapay Zekâ Modelleri Nasıl Eğitiliyor?
DPO, yapay zekâ modellerinin insan tercihlerine göre daha doğrudan eğitilmesini sağlayan bir yöntem. Peki Direct Preference Optimization nasıl çalışıyor ve RLHF'ten hangi yönleriyle ayrılıyor?
23/08/2026 15:37 | Son Güncelleme : 16/09/2026 18:53 | Netosfer
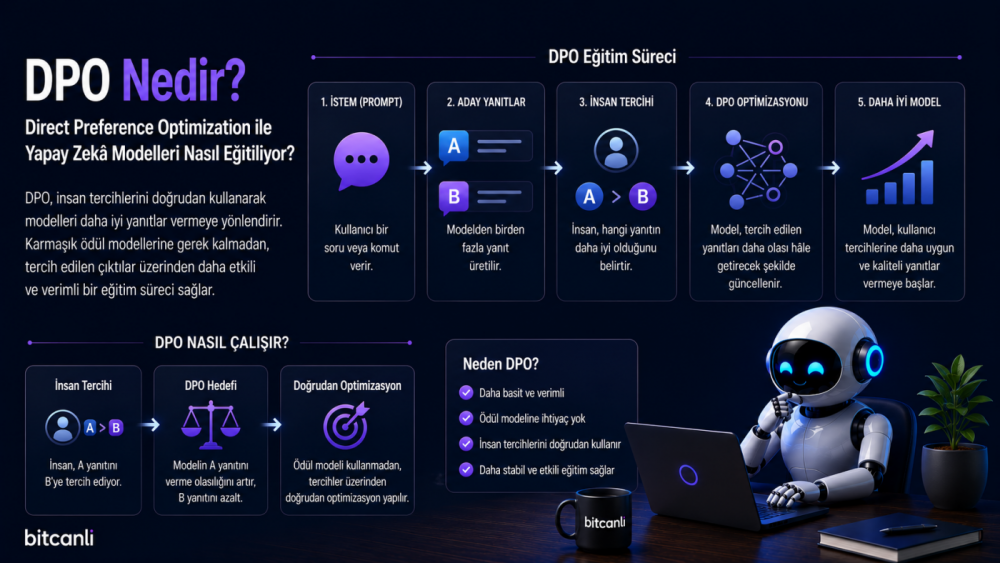
Büyük dil modellerini insan tercihlerine göre hizalamak için uzun süre RLHF (Reinforcement Learning from Human Feedback) yaklaşımı kullanıldı. Ancak RLHF; tercih verilerinden bir Reward Model oluşturulması ve ardından pekiştirmeli öğrenme ile politika modelinin optimize edilmesi gibi daha karmaşık bir eğitim süreci gerektirebilir.
2023 yılında tanıtılan DPO (Direct Preference Optimization) ise insan tercihlerini daha doğrudan kullanarak model davranışını optimize eden alternatif bir yaklaşım sundu. DPO'nun temel amacı, RLHF'teki ödül modelleme ve ayrı RL optimizasyon sürecini daha basit bir tercih optimizasyon kaybıyla ele almaktır.
DPO Nedir?
DPO (Direct Preference Optimization), büyük dil modellerini tercih verileri üzerinden hizalamak için geliştirilen bir optimizasyon yöntemidir.
DPO'da aynı istem için oluşturulan iki cevap arasından hangisinin tercih edildiği bilgisi kullanılır. Model, tercih edilen cevabın olasılığını artırırken reddedilen cevabın göreli olasılığını azaltacak şekilde eğitilir.
Bu yaklaşım;
- Eğitim sürecini sadeleştirebilir.
- Ayrı bir Reward Model ihtiyacını ortadan kaldırabilir.
- PPO tabanlı RLHF'e kıyasla daha basit bir eğitim süreci sunabilir.
- İnsan tercihlerini doğrudan optimizasyon sürecine dahil edebilir.
DPO Nasıl Çalışır?
Genel süreç şu şekilde ilerler:
1. Önceden Eğitilmiş Model Hazırlanır
Temel büyük dil modeli eğitim için hazırlanır.
2. Tercih Verileri Toplanır
Aynı istem için birden fazla cevap oluşturulur ve tercih edilen cevap belirlenir.
Örneğin:
Soru: "Yapay zekâ nedir?"
Tercih edilen cevap: Daha doğru, anlaşılır ve faydalı cevap.
Reddedilen cevap: Daha düşük kaliteli veya daha az uygun cevap.
3. Tercih Çiftleri Oluşturulur
Eğitim verisinde genellikle;
- Prompt
- Chosen response
- Rejected response
bilgileri bulunur.
4. Model Tercihlere Göre Optimize Edilir
DPO kaybı, modelin tercih edilen cevabı referans modele göre daha yüksek olasılıkla üretmesini teşvik ederken reddedilen cevabı daha düşük olasılıklı hâle getirmeye çalışır.
5. Model Güncellenir
Eğitim tamamlandığında model, verilen tercih verilerindeki davranışlara daha fazla uyum sağlayabilir.
Hugging Face TRL gibi güncel eğitim araçları DPO için doğrudan DPOTrainer sunmaktadır.
DPO Neden Önemlidir?
Klasik RLHF yaklaşımında tercih verilerinden bir Reward Model öğrenilir ve ardından politika modeli pekiştirmeli öğrenme ile optimize edilir.
DPO ise bu süreci daha doğrudan ele alır.
Bu nedenle;
- Daha basit bir eğitim hattı oluşturulabilir.
- Ayrı Reward Model eğitimi gerekmeyebilir.
- PPO tabanlı RL döngüsüne ihtiyaç duyulmaz.
- Araştırma ve fine-tuning süreçleri daha kolay uygulanabilir.
Ancak bu, DPO'nun her durumda daha iyi olduğu anlamına gelmez. Sonuçlar kullanılan tercih verisine, modele, hiperparametrelere ve görev türüne bağlıdır.
DPO'nun Avantajları
Daha Basit Eğitim
DPO, RLHF'in çok aşamalı eğitim hattını sadeleştirmeyi amaçlar.
Reward Model Gerektirmez
DPO'nun temel eğitiminde ayrı bir Reward Model oluşturulmasına gerek yoktur.
Daha Kolay Uygulama
Günümüzde Hugging Face TRL gibi araçlar DPO eğitimini doğrudan desteklemektedir.
Tercih Verisini Doğrudan Kullanır
Model, hangi cevabın tercih edildiğini doğrudan eğitim sinyali olarak kullanır.
Farklı Model Türlerine Uyarlanabilir
DPO yaklaşımının yalnızca metin modelleriyle sınırlı kalmadığını gösteren çalışmalar da bulunmaktadır. Örneğin Diffusion-DPO, görsel üretim modellerini insan tercihleriyle hizalamak için DPO yaklaşımını uyarlamıştır.
Karşılaşılan Zorluklar
Tercih Verisinin Kalitesi
DPO'nun başarısı büyük ölçüde kullanılan tercih verisinin kalitesine bağlıdır.
Veri Yanlılığı
Değerlendiricilerin veya veri setinin önyargıları model davranışına yansıyabilir.
Tercihlerin Öznel Olması
İnsanların aynı cevapları aynı şekilde değerlendirmesi her zaman mümkün değildir.
Referans Model
DPO'nun standart formülasyonunda politika modelinin referans modele göre nasıl değiştiği önemli bir rol oynar. Uygulama çerçeveleri de referans model kullanımını destekler.
Aşırı Uyum
Model, tercih veri setindeki davranışlara fazla uyum sağlayarak farklı görevlerde beklenenden daha düşük performans gösterebilir.
Nerelerde Kullanılıyor?
Büyük Dil Modelleri
LLM'lerin insan tercihlerine göre hizalanmasında.
AI Chatbot
Yanıt kalitesini ve kullanıcı beklentilerine uyumu geliştirmede.
Kod Üreten Modeller
Kod cevaplarının tercih edilen özelliklere göre optimize edilmesinde.
AI Agent
Ajanların belirli görevlerde daha uygun davranışlar öğrenmesinde.
Kurumsal Yapay Zekâ
Şirket politikalarına veya kullanıcı beklentilerine uygun model davranışlarının geliştirilmesinde.
Görsel Üretim
DPO'nun uyarlanmış versiyonları, görsel üretim modellerini insan tercihlerine göre hizalamak için de kullanılabilir.
DPO ile RLHF Arasındaki Fark
RLHF
RLHF, insan geri bildirimlerinden yararlanarak model davranışını hizalamaya yönelik daha geniş bir eğitim yaklaşımıdır. Yaygın klasik uygulamalarda Reward Model ve PPO gibi bir RL aşaması bulunabilir.
DPO
DPO, tercih verilerinden doğrudan optimizasyon yaparak bu süreci daha basit bir kayıp fonksiyonuyla ele alır.
Kısaca:
RLHF → Tercih verisi + Reward Model + RL optimizasyonu
DPO → Tercih verisi + Doğrudan optimizasyon
DPO'nun ortaya çıkışındaki temel motivasyonlardan biri de RLHF sürecinin karmaşıklığını azaltmaktır.
DPO ile SFT Arasındaki Fark
SFT (Supervised Fine-Tuning)
Model, örnek giriş ve hedef cevaplardan oluşan veriyle eğitilir.
DPO
Model, aynı istem için hangi cevabın tercih edildiğini gösteren karşılaştırmalı verilerden öğrenir.
Bu nedenle SFT ve DPO birbirinin doğrudan alternatifi olmak zorunda değildir. Bir model önce SFT ile temel davranışlara göre eğitilip ardından DPO ile tercih verilerine göre hizalanabilir.
DPO ile Preference Learning Arasındaki Fark
Preference Learning
İnsan veya kullanıcı tercihlerini öğrenmeyi amaçlayan daha geniş yaklaşımı ifade eder.
DPO
Bu tercihlerden yararlanarak modeli doğrudan optimize eden belirli bir yöntemdir.
Yani:
Preference Learning → Geniş yaklaşım
DPO → Belirli optimizasyon yöntemi
Gelecekte DPO
DPO, günümüzde LLM post-training ekosisteminde kullanılan yöntemlerden biri olmaya devam ediyor. Hugging Face TRL gibi araçların DPO'yu doğrudan desteklemesi, yöntemin pratik eğitim süreçlerinde kullanılabildiğini gösteriyor.
Önümüzdeki dönemde;
- Yeni DPO varyasyonlarının geliştirilmesi,
- Çok modlu modellerde tercih optimizasyonunun yaygınlaşması,
- AI Agent davranışlarının tercih verileriyle iyileştirilmesi,
- Daha kaliteli preference dataset'lerinin oluşturulması,
- DPO'nun diğer post-training yöntemleriyle birlikte kullanılması
gibi çalışmaların devam etmesi beklenebilir.
DPO'nun RLHF'in tamamen yerini alacağını söylemek ise doğru değildir. Her yöntemin avantajları ve kullanım alanları farklıdır.
Sık Sorulan Sorular
DPO nedir?
DPO, büyük dil modellerini tercih verileri üzerinden doğrudan optimize ederek insan beklentilerine daha uygun davranışlar kazandırmayı amaçlayan hizalama yöntemidir.
DPO neden önemlidir?
Reward Model ve ayrı bir PPO tabanlı RL aşamasına ihtiyaç duymadan tercih optimizasyonu yapabilmesi, eğitim sürecini sadeleştirebilir.
DPO ile RLHF aynı mı?
Hayır. DPO, RLHF'e alternatif daha doğrudan bir tercih optimizasyon yaklaşımıdır.
DPO ile SFT aynı mı?
Hayır. SFT doğru cevap örnekleriyle öğrenirken DPO tercih edilen ve reddedilen cevaplar arasındaki farktan yararlanır.
DPO gelecekte daha yaygın olacak mı?
DPO hâlihazırda LLM post-training araçlarında destekleniyor ve tercih optimizasyonu alanında aktif olarak kullanılmaya devam ediyor.
Kaynaklar
Stanford – Direct Preference Optimization: Your Language Model is Secretly a Reward Model, Hugging Face TRL Documentation, IEEE Xplore Digital Library, arXiv – A Comprehensive Survey of Direct Preference Optimization, arXiv – A Survey of Direct Preference Optimization, Ultralytics – Direct Preference Optimization Overview
Editör Notu
Bu içerik Bitcanlı Editörü tarafından hazırlanmıştır. İçerikte yer alan bilgiler yalnızca bilgilendirme amacı taşımaktadır. DPO (Direct Preference Optimization), büyük dil modellerinin tercih verileri üzerinden daha doğrudan ve sade bir şekilde hizalanmasını sağlayan modern post-training yöntemlerinden biridir. Güncel akademik araştırmaların, teknik dokümantasyonun ve açık kaynak projelerin düzenli olarak takip edilmesi önerilir.






Bunlar da ilginizi çekebilir
-i6a7b8e2f41de7-700x394.png)
Yapay Zekâ Şirketleri Kendi İnternetini Kuruyor: AI Trafiği Neden Bu Kadar Büyüdü?
Yapay zekâ sistemleri büyüdükçe binlerce GPU arasında taşınan veri de artıyor. AI networking teknolojileri, teknoloji şirketlerinin veri merkezi altyapısını yeniden şekillendiriyor.
1 ay önce
Inference Labs Nedir? Doğrulanabilir Yapay Zekâ (Verifiable AI) Altyapısı Nasıl Çalışır?
Yapay zekâ bir sonuç ürettiğinde ona neden güvenelim? Inference Labs, AI çıktılarının gerçekten nasıl üretildiğini kriptografik kanıtlarla doğrulamayı amaçlıyor.
1 ay önce
Atoma Network Nedir? Merkeziyetsiz Yapay Zekâ Çıkarım (AI Inference) Ağı Nasıl Çalışır?
Yapay zekâ çalışırken verileriniz ve modelin kendisi gerçekten güvende mi? Atoma, AI çıkarımını merkeziyetsiz altyapı, doğrulanabilir hesaplama ve gizli işlem teknolojileriyle yeniden ele alıyor.
1 ay önce