
-i6a77249e192b0.png)

GRPO Nedir? Group Relative Policy Optimization ile Yapay Zekâ Modelleri Nasıl Daha İyi Akıl Yürütüyor?
GRPO, yapay zekâ modelinin aynı soruya verdiği birden fazla cevabı karşılaştırarak daha başarılı çözüm yollarını öğrenmesini sağlıyor. Peki Group Relative Policy Optimization nasıl çalışıyor?
23/08/2026 15:24 | Son Güncelleme : 16/09/2026 18:54 | Netosfer
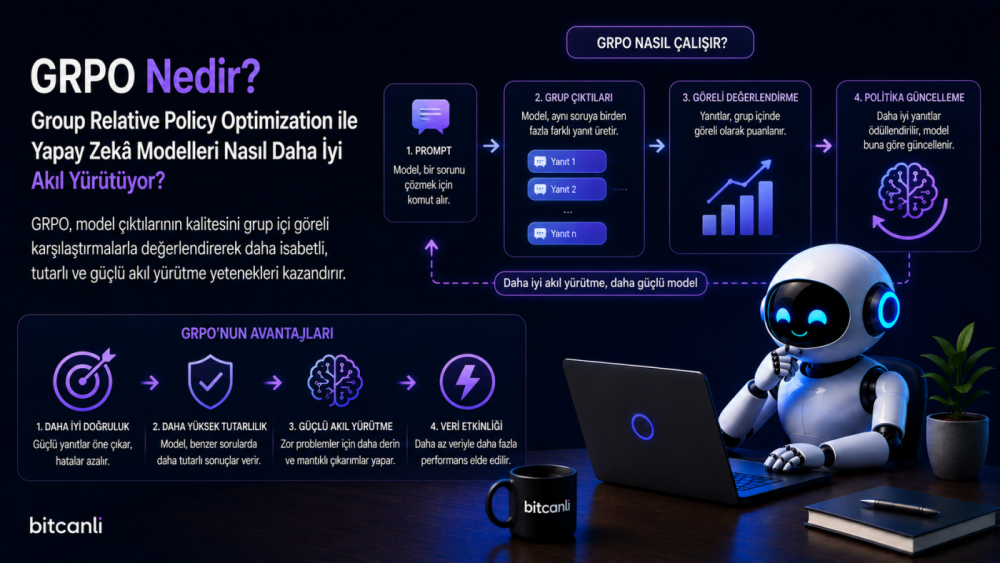
Büyük dil modellerinin gelişiminde RLHF ve DPO önemli yöntemler arasında yer alıyor. Ancak matematik, kod üretimi ve çok adımlı akıl yürütme (reasoning) gibi görevlerde modelin yalnızca tercih edilen cevabı öğrenmesi yeterli olmayabiliyor.
Bu noktada GRPO (Group Relative Policy Optimization), aynı isteme üretilen birden fazla cevabı grup içinde karşılaştırarak modelin daha başarılı çözüm yollarını öğrenmesini sağlayan pekiştirmeli öğrenme yaklaşımı olarak öne çıkıyor.
Özellikle DeepSeek-R1 ile birlikte GRPO, reasoning odaklı büyük dil modellerinin eğitiminde dikkat çeken yöntemlerden biri hâline geldi.
GRPO Nedir?
GRPO (Group Relative Policy Optimization), büyük dil modellerinin aynı istem için ürettiği birden fazla cevabı grup içinde karşılaştırarak göreceli ödüllere göre optimize edilmesini sağlayan pekiştirmeli öğrenme yöntemidir.
GRPO'nun temel fikri, her cevabı tamamen bağımsız değerlendirmek yerine aynı soruya verilen cevapların birbirlerine göre ne kadar başarılı olduğunu dikkate almaktır.
Bu yaklaşım;
- Reasoning performansının geliştirilmesine,
- Matematik ve kod görevlerinde daha başarılı sonuçlar alınmasına,
- Bazı RL eğitim süreçlerinde bellek kullanımının azaltılmasına,
- Modelin daha başarılı çözüm stratejilerini öğrenmesine
yardımcı olabilir.
GRPO Nasıl Çalışır?
Genel süreç şu şekilde ilerler:
1. Bir İstem Verilir
Örneğin:
"Bu matematik problemini çöz."
2. Model Birden Fazla Cevap Üretir
Model aynı problem için bir grup farklı çözüm oluşturur.
3. Cevaplar Değerlendirilir
Cevapların başarısı bir ödül mekanizmasıyla ölçülür.
Örneğin;
- Doğruluk,
- Sonucun geçerliliği,
- Görevin tamamlanması,
- Belirlenen kurallara uyum
gibi kriterler kullanılabilir.
4. Grup İçinde Göreceli Değerlendirme Yapılır
Cevapların aldığı ödüller grup içinde karşılaştırılır.
Daha başarılı cevaplar daha yüksek göreceli avantaj elde ederken, daha zayıf cevapların avantajı daha düşük olur.
5. Model Güncellenir
Model, daha yüksek ödül alan çözüm biçimlerini üretme olasılığını artıracak şekilde optimize edilir.
Bu süreç farklı istemler üzerinde tekrarlandıkça modelin belirli görevlerdeki performansı geliştirilebilir.
GRPO Neden Önemlidir?
Geleneksel pekiştirmeli öğrenme yöntemlerinde modelin performansını değerlendirmek için ek bileşenlere ve daha yüksek hesaplama kaynaklarına ihtiyaç duyulabilir.
GRPO'nun önemli özelliklerinden biri, aynı istem için üretilen cevapların grup içindeki göreceli performansından yararlanmasıdır.
Bu yaklaşım özellikle sonucu otomatik olarak kontrol edilebilen görevlerde avantaj sağlayabilir.
Örneğin;
- Matematik problemleri,
- Kodlama görevleri,
- Mantık problemleri
gibi alanlarda doğru veya yanlış sonuçların otomatik değerlendirilebilmesi, ödül mekanizmasının kurulmasını kolaylaştırabilir.
GRPO'nun Avantajları
Güçlü Reasoning
Çok adımlı problem çözme görevlerinde modelin daha başarılı çözüm stratejileri öğrenmesine yardımcı olabilir.
Daha Verimli RL Eğitimi
GRPO, klasik PPO'daki ayrı bir değer modeline duyulan ihtiyacı ortadan kaldıran tasarımıyla bazı eğitim senaryolarında bellek kullanımını azaltabilir.
Göreceli Değerlendirme
Cevapların yalnızca mutlak puanına değil, aynı istem için oluşturulan diğer cevaplara göre performansına da bakılır.
Matematik ve Kodlama
Sonucun otomatik olarak doğrulanabildiği görevlerde özellikle kullanışlı olabilir.
Ölçeklenebilirlik
Büyük dil modellerinin reasoning yeteneklerini geliştirmek için uygulanabilecek RL yaklaşımlarından biridir.
Karşılaşılan Zorluklar
Hesaplama Maliyeti
Her istem için birden fazla cevap üretilmesi ek hesaplama gerektirir.
Ödül Tasarımı
Modelin neyi öğrenmesi gerektiğini doğru şekilde yönlendirecek ödül mekanizmasının oluşturulması kritik öneme sahiptir.
Ödül Hileleri
Model, gerçek problemi çözmek yerine ödül sisteminin açıklarından yararlanabilecek davranışlar geliştirebilir.
Eğitim Süreci
RL tabanlı eğitim, standart fine-tuning süreçlerine göre daha karmaşık olabilir.
Genelleme
Bir görevde başarılı olan reasoning davranışı farklı görevlerde aynı ölçüde başarılı olmayabilir.
Nerelerde Kullanılıyor?
Reasoning Modelleri
Matematik, mantık ve çok adımlı problem çözme görevlerinde.
Kod Üreten Modeller
Programlama ve kod doğrulama görevlerinde.
AI Agent
Planlama, karar verme ve çok adımlı görevlerde.
Akademik Araştırmalar
Yeni pekiştirmeli öğrenme yöntemlerinin geliştirilmesinde.
Bilimsel Problem Çözme
Sonuçların doğrulanabildiği karmaşık analiz görevlerinde.
Açık Kaynak LLM
Reasoning odaklı fine-tuning ve RL çalışmalarında.
GRPO ile PPO Arasındaki Fark
PPO (Proximal Policy Optimization)
PPO, pekiştirmeli öğrenmede yaygın kullanılan genel bir politika optimizasyon yöntemidir ve tipik uygulamalarda politika modelinin yanında bir değer tahmin mekanizmasından yararlanır.
GRPO
GRPO, aynı istem için oluşturulan bir grup cevabın ödüllerini karşılaştırarak göreceli avantajlar hesaplar ve bu yapıyla politika optimizasyonu gerçekleştirir.
Kısaca:
PPO → Değer tahminiyle politika optimizasyonu
GRPO → Grup içi göreceli ödüllerle politika optimizasyonu
GRPO ile DPO Arasındaki Fark
DPO
Direct Preference Optimization (DPO), tercih edilen ve edilmeyen cevap çiftlerinden yararlanarak modeli doğrudan optimize eden bir yöntemdir.
GRPO
GRPO ise modelin aynı istem için ürettiği birden fazla cevabı ödül sinyalleri üzerinden grup içinde karşılaştırarak pekiştirmeli öğrenme gerçekleştirir.
Kısaca:
DPO → Tercih verisi
GRPO → Ödül ve grup içi göreceli değerlendirme
GRPO ile RLHF Arasındaki İlişki
RLHF, insan geri bildirimlerini kullanarak modelleri hizalamaya yönelik daha geniş bir eğitim yaklaşımıdır.
GRPO ise pekiştirmeli öğrenme aşamasında kullanılabilecek belirli bir politika optimizasyon yöntemidir.
Dolayısıyla GRPO ile RLHF doğrudan aynı kategorideki iki yöntem değildir.
Gelecekte GRPO
Reasoning odaklı yapay zekâ modellerinin gelişmesiyle birlikte grup tabanlı RL yöntemlerine yönelik araştırmaların devam etmesi bekleniyor.
Özellikle;
- Matematik ve kodlama gibi doğrulanabilir görevlerde,
- Reasoning modellerinde,
- AI Agent sistemlerinde,
- Açık kaynak LLM eğitiminde,
- Daha verimli RL algoritmalarının geliştirilmesinde
GRPO benzeri yöntemler önemli bir araştırma alanı olmaya devam edebilir.
Ancak GRPO'nun tüm yapay zekâ eğitim senaryolarında standart yöntem hâline geleceğini şimdiden söylemek mümkün değildir. Performansı; görev türüne, ödül mekanizmasına, model mimarisine ve eğitim stratejisine bağlıdır.
Sık Sorulan Sorular
GRPO nedir?
Aynı istem için üretilen birden fazla cevabı grup içinde karşılaştırarak büyük dil modellerini optimize eden pekiştirmeli öğrenme yöntemidir.
GRPO neden önemlidir?
Özellikle matematik, kodlama ve reasoning gibi ödülün otomatik olarak değerlendirilebildiği görevlerde model performansını geliştirmek için kullanılabilir.
GRPO ile PPO aynı mı?
Hayır. GRPO, grup içindeki cevapların göreceli ödüllerinden yararlanırken PPO farklı bir politika optimizasyon tasarımına dayanır.
GRPO ile DPO aynı mı?
Hayır. DPO tercih verilerinden doğrudan öğrenirken GRPO, model çıktılarının ödüllerini grup içinde karşılaştırarak RL optimizasyonu gerçekleştirir.
GRPO hangi modellerle öne çıktı?
GRPO özellikle DeepSeek-R1 ile birlikte reasoning odaklı model eğitiminde geniş ilgi gördü.
GRPO gelecekte daha yaygın olacak mı?
Özellikle reasoning, matematik, kodlama ve doğrulanabilir görevlerde kullanımının ve araştırmalarının devam etmesi beklenmektedir.
Kaynaklar
DeepSeek AI – DeepSeek-R1 Technical Report, Hugging Face TRL Documentation, IEEE Xplore Digital Library, arXiv – DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning, arXiv – Group Relative Policy Optimization for Large Language Models, Papers with Code – Reinforcement Learning for LLMs
Editör Notu
Bu içerik Bitcanlı Editörü tarafından hazırlanmıştır. İçerikte yer alan bilgiler yalnızca bilgilendirme amacı taşımaktadır. GRPO, özellikle reasoning odaklı büyük dil modellerinin eğitiminde öne çıkan pekiştirmeli öğrenme yaklaşımlarından biridir. Güncel akademik araştırmaların, teknik raporların ve açık kaynak projelerin düzenli olarak takip edilmesi önerilir.






Bunlar da ilginizi çekebilir
-i6a7b8e2f41de7-700x394.png)
Yapay Zekâ Şirketleri Kendi İnternetini Kuruyor: AI Trafiği Neden Bu Kadar Büyüdü?
Yapay zekâ sistemleri büyüdükçe binlerce GPU arasında taşınan veri de artıyor. AI networking teknolojileri, teknoloji şirketlerinin veri merkezi altyapısını yeniden şekillendiriyor.
1 ay önce
Inference Labs Nedir? Doğrulanabilir Yapay Zekâ (Verifiable AI) Altyapısı Nasıl Çalışır?
Yapay zekâ bir sonuç ürettiğinde ona neden güvenelim? Inference Labs, AI çıktılarının gerçekten nasıl üretildiğini kriptografik kanıtlarla doğrulamayı amaçlıyor.
1 ay önce
Atoma Network Nedir? Merkeziyetsiz Yapay Zekâ Çıkarım (AI Inference) Ağı Nasıl Çalışır?
Yapay zekâ çalışırken verileriniz ve modelin kendisi gerçekten güvende mi? Atoma, AI çıkarımını merkeziyetsiz altyapı, doğrulanabilir hesaplama ve gizli işlem teknolojileriyle yeniden ele alıyor.
1 ay önce