
-i6a77249e192b0.png)

Preference Learning Nedir? Yapay Zekâ İnsan Tercihlerini Nasıl Öğreniyor?
Preference Learning, yapay zekânın yalnızca doğru cevabı değil, insanların daha faydalı ve uygun bulduğu cevabı öğrenmesini sağlıyor. Peki insan tercihleri AI modellerinin davranışlarına nasıl aktarılıyor?
23/08/2026 15:22 | Son Güncelleme : 16/09/2026 18:54 | Netosfer
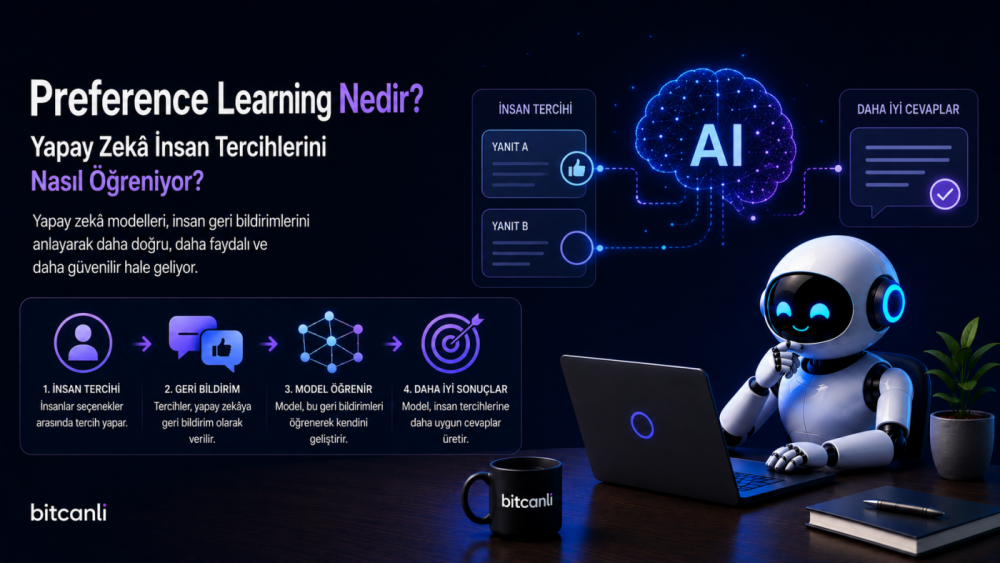
Yapay zekâ modellerinin yalnızca doğru cevaplar üretmesi her zaman yeterli değildir. Aynı soruya teknik olarak doğru birden fazla yanıt verilebilir. Ancak kullanıcı bu yanıtların birini daha anlaşılır, doğal, güvenli veya faydalı bulabilir.
Yapay zekânın bu tür insan tercihlerini öğrenmesini sağlayan yaklaşımların genel adı Preference Learning (Tercih Öğrenmesi) olarak kullanılır.
Preference Learning; RLHF, DPO ve benzeri modern hizalama yöntemlerinin temelinde yer alan önemli yaklaşımlardan biridir. Özellikle büyük dil modellerinin kullanıcı beklentilerine daha uygun yanıtlar üretmesinde önemli rol oynar.
Preference Learning Nedir?
Preference Learning, yapay zekâ modellerinin yalnızca doğru cevapları değil, insanlar tarafından hangi cevapların daha fazla tercih edildiğini öğrenmesini sağlayan makine öğrenmesi yaklaşımıdır.
Bu sayede model;
- Daha doğal yanıtlar üretebilir.
- Kullanıcı beklentilerine daha iyi uyum sağlayabilir.
- Daha faydalı cevaplar oluşturabilir.
- Güvenlik ve kalite açısından tercih edilen davranışları öğrenebilir.
Buradaki temel fikir, modele yalnızca "Bu cevap doğru mu?" sorusunu değil, "Bu cevap diğerine göre daha mı iyi?" sorusunu da öğretebilmektir.
Preference Learning Nasıl Çalışır?
Genel süreç şu şekilde ilerler:
1. Birden Fazla Cevap Üretilir
Aynı soruya veya göreve karşılık model tarafından farklı cevaplar oluşturulur.
2. Cevaplar Karşılaştırılır
İnsan değerlendiriciler veya bazı sistemlerde başka bir yapay zekâ modeli, cevapları belirlenen kriterlere göre karşılaştırabilir.
3. Tercih Verisi Oluşturulur
Hangi cevabın diğerine göre tercih edildiği kaydedilir.
Örneğin:
Cevap A > Cevap B
şeklinde bir tercih çifti oluşturulabilir.
4. Tercih Modeli Öğrenir
Model, tercih edilen cevapların hangi özelliklere sahip olduğunu öğrenmeye başlar.
5. Eğitim Sürecinde Kullanılır
Oluşturulan tercih verileri RLHF veya DPO gibi farklı hizalama yöntemlerinde kullanılabilir.
Preference Learning Neden Önemlidir?
Bir yapay zekâ sisteminin yalnızca doğru bilgi vermesi, iyi bir kullanıcı deneyimi için yeterli olmayabilir.
Örneğin iki cevap da doğru olabilir. Ancak kullanıcı;
- Daha anlaşılır,
- Daha kısa,
- Daha güvenli,
- Daha ayrıntılı,
- Daha doğrudan
olan cevabı tercih edebilir.
Preference Learning, bu tür tercihleri model davranışına yansıtmayı amaçlar.
Bu nedenle özellikle insanlarla doğrudan etkileşim kuran chatbot, AI Copilot ve AI Agent sistemlerinde önemli bir rol oynar.
Preference Learning Türleri
Pairwise Preference Learning
İki farklı cevap karşılaştırılır ve hangisinin tercih edildiği belirlenir.
Örneğin:
A cevabı > B cevabı
Listwise Preference Learning
Birden fazla cevap aynı anda değerlendirilerek sıralanır.
Explicit Preference Learning
Kullanıcı doğrudan değerlendirme yapar.
Örneğin bir cevaba olumlu veya olumsuz geri bildirim vermesi gibi.
Implicit Preference Learning
Kullanıcının davranışlarından tercih çıkarılmaya çalışılır.
Örneğin hangi arama sonucuna tıkladığı veya hangi öneriyi seçtiği gibi davranışlar değerlendirilebilir.
Nerelerde Kullanılıyor?
Büyük Dil Modelleri
Chatbot ve üretici yapay zekâ modellerinin hizalanmasında.
AI Agent
Ajanların hangi karar veya davranışlarının tercih edildiğini öğrenmesinde.
Arama Motorları
Arama sonuçlarının kullanıcı tercihleri doğrultusunda sıralanmasında.
Tavsiye Sistemleri
Film, müzik, ürün ve içerik önerilerinde.
Kod Üreten Modeller
Daha kaliteli ve kullanıcı beklentilerine uygun kod üretiminde.
Kurumsal Yapay Zekâ
Şirket politikaları ve kullanıcı ihtiyaçlarına uygun yanıtların geliştirilmesinde.
Preference Learning'in Avantajları
Daha Doğal Yanıtlar
Model, insanların daha doğal bulduğu cevap biçimlerini öğrenebilir.
Daha Güçlü Alignment
Model davranışlarının insan tercihleriyle daha uyumlu hâle getirilmesine yardımcı olabilir.
Daha İyi Kullanıcı Deneyimi
Kullanıcıların faydalı bulduğu yanıtların üretilme olasılığı artırılabilir.
Kişiselleştirme
Sistemin farklı kullanıcıların tercihlerini dikkate almasına yardımcı olabilir.
Karşılaşılan Zorluklar
Öznel Tercihler
İnsanların aynı cevap hakkındaki değerlendirmeleri farklı olabilir.
Veri Kalitesi
Tutarsız veya hatalı tercih verileri modelin yanlış davranışlar öğrenmesine neden olabilir.
Kültürel Farklılıklar
Bir toplumda tercih edilen cevap başka bir toplumda aynı şekilde değerlendirilmeyebilir.
Ölçeklenebilirlik
Büyük miktarda kaliteli tercih verisi toplamak maliyetli ve zaman alıcı olabilir.
Tercihlerin Değişmesi
Kullanıcı beklentileri zaman içinde değişebilir. Bu nedenle tercih verilerinin güncel tutulması önemlidir.
Preference Learning ile RLHF Arasındaki Fark
Preference Learning
İnsan veya kullanıcı tercihlerinin öğrenilmesini amaçlayan daha geniş bir yaklaşımdır.
RLHF
İnsan geri bildirimlerinden elde edilen tercihleri pekiştirmeli öğrenme sürecinde kullanarak modeli hizalamayı amaçlayan belirli bir eğitim yöntemidir.
Kısaca:
Preference Learning → Tercihleri öğrenme yaklaşımı
RLHF → Bu tercihlerden yararlanan hizalama yöntemi
Preference Learning ile DPO Arasındaki Fark
DPO
Direct Preference Optimization (DPO), tercih verilerini kullanarak modeli doğrudan optimize etmeyi amaçlayan bir yöntemdir.
Preference Learning
Tercih verilerinin elde edilmesi ve kullanılmasını kapsayan daha geniş bir kavramdır.
Dolayısıyla DPO, Preference Learning ekosisteminde kullanılan yöntemlerden biridir.
Preference Learning ile RLAIF Arasındaki Fark
Preference Learning
Tercih edilen ve edilmeyen çıktıları belirleyerek modelin bu tercihleri öğrenmesini amaçlar.
RLAIF
Reinforcement Learning from AI Feedback, insan yerine bir yapay zekâ sisteminin geri bildiriminden yararlanır.
Bu nedenle RLAIF kapsamında da AI tarafından oluşturulan tercih verilerinden yararlanılabilir.
Gelecekte Preference Learning
Yapay zekâ sistemleri daha kişiselleştirilmiş hâle geldikçe kullanıcı tercihlerinin öğrenilmesi daha önemli bir konu olmaya devam edecek.
Gelecekte;
- AI Agent sistemlerinde kişiselleştirme gelişebilir.
- Kullanıcı davranışlarından otomatik tercih çıkarımı yaygınlaşabilir.
- Çok modlu sistemler metin, görsel ve ses tercihlerini birlikte değerlendirebilir.
- AI Alignment araştırmalarında Preference Learning önemli bir yöntem olmaya devam edebilir.
- Kişiye özel AI Copilot ve dijital asistan deneyimleri gelişebilir.
Ancak Preference Learning'in amacı yalnızca kullanıcıyı memnun etmek değildir. Tercih verisinin kalitesi, güvenlik, önyargı ve insan değerleriyle uyum gibi konular da sistem tasarımında dikkate alınmalıdır.
Sık Sorulan Sorular
Preference Learning nedir?
Yapay zekâ modellerinin insanların hangi cevapları veya davranışları tercih ettiğini öğrenmesini sağlayan makine öğrenmesi yaklaşımıdır.
Preference Learning neden önemlidir?
Modelin yalnızca doğru cevaplar değil, kullanıcıların daha faydalı ve uygun bulduğu cevaplar üretmesine yardımcı olabilir.
Preference Learning ile RLHF aynı mı?
Hayır. Preference Learning daha geniş bir kavramdır. RLHF ise insan geri bildirimlerinden elde edilen tercihlerden yararlanan belirli bir hizalama yöntemidir.
DPO ile Preference Learning aynı mı?
Hayır. DPO, tercih verilerini kullanarak modeli doğrudan optimize eden belirli bir yöntemdir.
RLAIF Preference Learning ile ilişkili mi?
Evet. RLAIF kapsamında yapay zekâ tarafından oluşturulan değerlendirme ve tercih verilerinden yararlanılabilir.
Preference Learning gelecekte daha yaygın olacak mı?
Özellikle kişiselleştirilmiş yapay zekâ, AI Agent, AI Copilot ve model hizalama çalışmalarında kullanımının artması beklenmektedir.
Kaynaklar
OpenAI – Learning from Human Preferences, Anthropic Research – Constitutional AI, Hugging Face TRL Documentation, IEEE Xplore Digital Library, arXiv – Preference Learning: A Survey, arXiv – Learning from Human Preferences for AI Alignment
Editör Notu
Bu içerik Bitcanlı Editörü tarafından hazırlanmıştır. İçerikte yer alan bilgiler yalnızca bilgilendirme amacı taşımaktadır. Preference Learning, yapay zekâ modellerinin insan tercihlerini öğrenerek daha faydalı ve kullanıcı beklentilerine uygun davranmasını amaçlayan önemli yaklaşımlardan biridir. Güncel akademik araştırmaların, teknik raporların ve açık kaynak projelerin düzenli olarak takip edilmesi önerilir.






Bunlar da ilginizi çekebilir
-i6a7b8e2f41de7-700x394.png)
Yapay Zekâ Şirketleri Kendi İnternetini Kuruyor: AI Trafiği Neden Bu Kadar Büyüdü?
Yapay zekâ sistemleri büyüdükçe binlerce GPU arasında taşınan veri de artıyor. AI networking teknolojileri, teknoloji şirketlerinin veri merkezi altyapısını yeniden şekillendiriyor.
1 ay önce
Inference Labs Nedir? Doğrulanabilir Yapay Zekâ (Verifiable AI) Altyapısı Nasıl Çalışır?
Yapay zekâ bir sonuç ürettiğinde ona neden güvenelim? Inference Labs, AI çıktılarının gerçekten nasıl üretildiğini kriptografik kanıtlarla doğrulamayı amaçlıyor.
1 ay önce
Atoma Network Nedir? Merkeziyetsiz Yapay Zekâ Çıkarım (AI Inference) Ağı Nasıl Çalışır?
Yapay zekâ çalışırken verileriniz ve modelin kendisi gerçekten güvende mi? Atoma, AI çıkarımını merkeziyetsiz altyapı, doğrulanabilir hesaplama ve gizli işlem teknolojileriyle yeniden ele alıyor.
1 ay önce