
-i6a77249e192b0.png)

KV Cache Nedir? Büyük Dil Modelleri Aynı Hesaplamaları Tekrar Yapmadan Nasıl Daha Hızlı Çalışıyor?
KV Cache, büyük dil modellerinin önceki attention hesaplamalarını yeniden kullanarak inference sürecini daha hızlı ve verimli hâle getirmesini sağlayan temel optimizasyon tekniklerinden biridir.
23/08/2026 16:24 | Son Güncelleme : 16/09/2026 17:14 | Netosfer
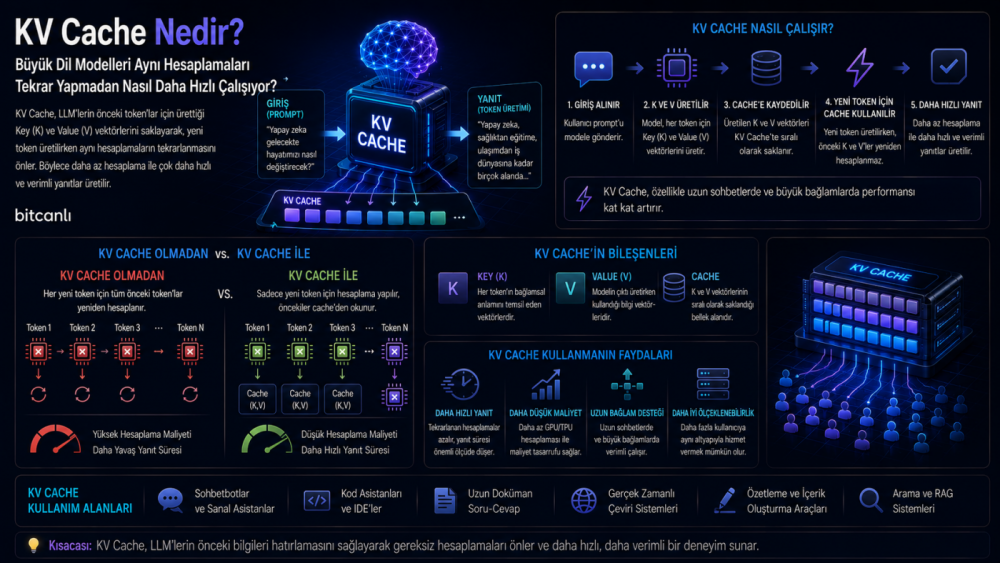
Büyük dil modelleri (LLM), metin üretirken her yeni token için önceki bağlamdan yararlanır. Önceki token'lara ait attention hesaplamaları her adımda yeniden yapılsaydı, özellikle uzun metinlerde inference süreci daha maliyetli ve yavaş hâle gelebilirdi.
Bu sorunu azaltmak için kullanılan KV Cache (Key-Value Cache), Transformer modellerinin attention katmanlarında daha önce hesaplanan Key ve Value değerlerini bellekte saklayarak sonraki token üretimlerinde yeniden kullanmasını sağlayan bir optimizasyon tekniğidir.
KV Cache, modern LLM inference altyapılarının önemli bileşenlerinden biridir. Ancak performans avantajının yanında GPU belleği tükettiği için cache yönetimi de büyük önem taşır.
KV Cache Nedir?
KV Cache (Key-Value Cache), Transformer mimarisindeki attention katmanlarında daha önce işlenen token'lara ait Key (K) ve Value (V) temsillerinin bellekte saklanarak sonraki token üretimlerinde yeniden kullanılmasını sağlayan önbellekleme yöntemidir.
Bu sayede model:
- Aynı Key ve Value hesaplamalarını tekrar yapmak zorunda kalmaz.
- Token üretimini daha verimli hâle getirebilir.
- Inference gecikmesini azaltabilir.
- Uzun metin üretiminde hesaplama maliyetini düşürebilir.
KV Cache Nasıl Çalışır?
Genel süreç şu şekilde ilerler:
1. İlk Token'lar İşlenir
Model, kullanıcı girdisindeki token'ları Transformer katmanlarından geçirir.
2. Key ve Value Değerleri Oluşturulur
Attention katmanları, işlenen token'lar için Key ve Value temsillerini hesaplar.
3. Değerler Cache'e Kaydedilir
Daha önce hesaplanan Key ve Value değerleri KV Cache içerisinde tutulur.
4. Yeni Token Üretilir
Model bir sonraki token'ı tahmin eder.
5. Önceki Değerler Yeniden Kullanılır
Geçmiş token'lar için Key ve Value değerleri yeniden hesaplanmak yerine cache'den alınır. Yeni token'a ait değerler cache'e eklenir.
6. Süreç Devam Eder
Her yeni token üretiminde mevcut cache kullanılır ve gerekli yeni değerler eklenir.
KV Cache Neden Önemlidir?
Autoregressive bir modelde her yeni token, önceki bağlama bağlı olarak üretilir. KV Cache kullanılmadığında geçmiş token'lara ait bazı attention hesaplamalarının tekrar gerçekleştirilmesi gerekir.
KV Cache sayesinde bu hesaplamaların önemli bir bölümü yeniden kullanılabilir.
Bunun sonucunda:
- Hesaplama tekrarı azalabilir.
- Inference gecikmesi düşebilir.
- Token üretimi daha verimli hâle gelebilir.
- Uzun bağlamlarda performans iyileştirilebilir.
KV Cache'in Avantajları
Daha Hızlı Yanıt
Geçmiş token'lara ait Key ve Value değerleri tekrar hesaplanmadığı için üretim daha verimli olabilir.
Daha Az Tekrarlı Hesaplama
Model, daha önce oluşturduğu attention bilgilerini yeniden kullanabilir.
Daha Düşük Gecikme
Özellikle gerçek zamanlı sohbet ve uzun metin üretiminde önemli avantaj sağlayabilir.
Inference Verimliliği
Büyük dil modellerinin yüksek hacimli istekleri daha verimli işlemesine yardımcı olabilir.
Karşılaşılan Zorluklar
Bellek Kullanımı
KV Cache, özellikle uzun bağlamlarda önemli miktarda GPU belleği tüketebilir.
Uzun Context
Bağlam uzunluğu arttıkça cache'in boyutu da büyüyebilir. Bu nedenle uzun context destekleyen modellerde cache yönetimi kritik hâle gelir.
Donanım Gereksinimi
Büyük modeller ve uzun bağlamlar daha fazla bellek gerektirebilir.
Cache Yönetimi
Dynamic Cache, Static Cache, Quantized Cache ve Offloaded Cache gibi farklı yaklaşımlar farklı bellek ve performans dengeleri sunar.
KV Cache Nerelerde Kullanılıyor?
Sohbet Botları
Uzun konuşmalarda önceki bağlamın daha verimli işlenmesinde.
AI Agent
Çok adımlı görevlerde inference performansını artırmak için.
Kod Üreten Modeller
Uzun kod üretim süreçlerinde.
RAG Sistemleri
Uzun belgelerle çalışan uygulamalarda.
Yerel LLM
Sınırlı GPU belleğine sahip sistemlerde inference optimizasyonu için.
KV Cache ile Context Window Arasındaki Fark
Context Window
Modelin bir istekte işleyebildiği toplam bağlam kapasitesini ifade eder.
KV Cache
Bu bağlamdaki daha önce işlenmiş token'ların attention hesaplamalarında kullanılan Key ve Value değerlerini saklar.
Dolayısıyla Context Window kapasiteyi, KV Cache ise inference sırasında kullanılan teknik önbelleği ifade eder.
KV Cache ile AI Memory Arasındaki Fark
AI Memory
Kullanıcı veya uygulama hakkında daha uzun süreli bilgilerin saklanmasını ifade eder.
KV Cache
Modelin inference sürecinde attention için oluşturduğu teknik ara değerleri geçici olarak saklar.
KV Cache, kullanıcı hafızası anlamına gelmez.
KV Cache ile Prompt Caching Arasındaki Fark
KV Cache
Attention katmanlarında oluşturulan Key ve Value değerlerini saklar ve sonraki token üretimlerinde yeniden kullanır.
Prompt Caching
Tekrar kullanılan bir prompt veya prompt öneki için daha önce gerçekleştirilmiş hesaplamaların yeniden kullanılmasını sağlayan daha üst düzey bir optimizasyon yaklaşımıdır.
İki yöntem benzer amaçlara hizmet edebilse de aynı mekanizma değildir. Hugging Face dokümantasyonu da cache yapılarının prefix caching gibi daha ileri kullanım senaryolarında değerlendirilebildiğini belirtmektedir.
Gelecekte KV Cache
LLM'lerin context window'ları ve kullanım ölçeği büyüdükçe KV Cache'in bellek maliyetini azaltmaya yönelik yöntemlerin önemi de artmaktadır.
Gelecekte:
- KV Cache quantization yöntemleri daha fazla kullanılabilir.
- Cache offloading teknikleri gelişebilir.
- Uzun context modelleri için daha verimli cache mimarileri geliştirilebilir.
- Prefix caching ve benzeri tekniklerle tekrar eden hesaplamalar azaltılabilir.
- Inference Engine'lerde KV Cache yönetimi daha gelişmiş hâle gelebilir.
Sık Sorulan Sorular
KV Cache nedir?
Transformer modellerinde attention katmanlarında oluşturulan Key ve Value değerlerini bellekte saklayarak sonraki token üretimlerinde yeniden kullanılmasını sağlayan inference optimizasyon tekniğidir.
KV Cache neden önemlidir?
Daha önce hesaplanan Key ve Value değerlerinin yeniden kullanılmasını sağlayarak tekrarlanan hesaplamaları azaltabilir ve inference sürecini hızlandırabilir.
KV Cache bellek kullanır mı?
Evet. Özellikle uzun bağlamlı modellerde KV Cache önemli miktarda GPU belleği tüketebilir.
KV Cache ile Context Window aynı mı?
Hayır. Context Window modelin işleyebildiği bağlam kapasitesini ifade ederken, KV Cache inference sırasında geçmiş token'ların Key ve Value değerlerini saklayan teknik bir önbellektir.
Gelecekte KV Cache daha önemli olacak mı?
Evet. Uzun bağlamlı ve yüksek kullanıcı sayısına sahip LLM sistemlerinde bellek verimliliği daha önemli hâle geldikçe KV Cache optimizasyonlarının da önemi artacaktır.
Kaynaklar
Hugging Face – KV Cache Documentation, Hugging Face – Caching Documentation, vLLM Documentation, NVIDIA AI Documentation, IEEE Xplore Digital Library, arXiv – Efficient Memory Management for Large Language Model Serving
Editör Notu
Bu içerik Bitcanli Editörü tarafından hazırlanmıştır. İçerikte yer alan bilgiler yalnızca bilgilendirme amacı taşımaktadır. KV Cache ve çıkarım optimizasyon teknikleri büyük dil modellerinin performansını artırmak için sürekli geliştirilmektedir. Güncel akademik araştırmaların, teknik raporların ve açık kaynak projelerin düzenli olarak takip edilmesi önerilir.






Bunlar da ilginizi çekebilir
-i6a7b8e2f41de7-700x394.png)
Yapay Zekâ Şirketleri Kendi İnternetini Kuruyor: AI Trafiği Neden Bu Kadar Büyüdü?
Yapay zekâ sistemleri büyüdükçe binlerce GPU arasında taşınan veri de artıyor. AI networking teknolojileri, teknoloji şirketlerinin veri merkezi altyapısını yeniden şekillendiriyor.
1 ay önce
Inference Labs Nedir? Doğrulanabilir Yapay Zekâ (Verifiable AI) Altyapısı Nasıl Çalışır?
Yapay zekâ bir sonuç ürettiğinde ona neden güvenelim? Inference Labs, AI çıktılarının gerçekten nasıl üretildiğini kriptografik kanıtlarla doğrulamayı amaçlıyor.
1 ay önce
Atoma Network Nedir? Merkeziyetsiz Yapay Zekâ Çıkarım (AI Inference) Ağı Nasıl Çalışır?
Yapay zekâ çalışırken verileriniz ve modelin kendisi gerçekten güvende mi? Atoma, AI çıkarımını merkeziyetsiz altyapı, doğrulanabilir hesaplama ve gizli işlem teknolojileriyle yeniden ele alıyor.
1 ay önce