
-i6a77249e192b0.png)

Speculative Decoding Nedir? Büyük Dil Modelleri Yanıtları Nasıl Daha Hızlı Üretiyor?
Speculative Decoding, küçük bir yapay zekâ modelinin olası token'ları önceden tahmin etmesi ve büyük modelin bu tahminleri doğrulaması sayesinde LLM'lerin daha hızlı yanıt üretmesini sağlayan önemli bir inference optimizasyon tekniğidir.
23/08/2026 16:22 | Son Güncelleme : 16/09/2026 17:13 | Netosfer
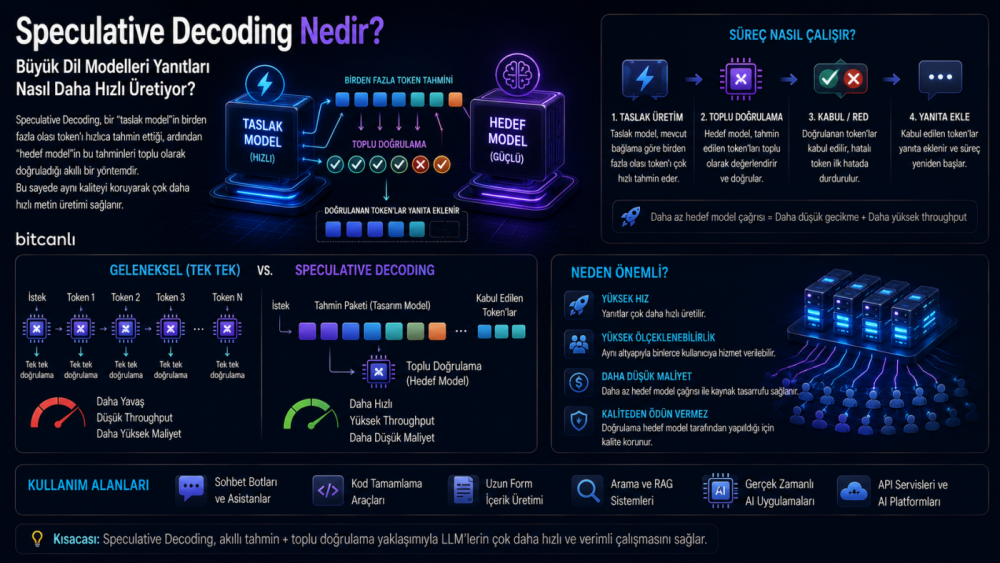
Büyük dil modelleri (LLM), metin üretirken her yeni token için karmaşık hesaplamalar gerçekleştirir. Özellikle milyarlarca parametreye sahip modellerde bu süreç yüksek işlem gücü gerektirir ve yanıt süresini uzatabilir.
Bu sorunu çözmek için geliştirilen Speculative Decoding (Tahmine Dayalı Kod Çözme), küçük ve hızlı bir modelin olası token'ları önceden tahmin etmesi, büyük modelin ise bu tahminleri doğrulaması esasına dayanır.
Bu teknik sayesinde büyük model, her token'ı tek tek üretmek yerine birden fazla token'ı aynı anda değerlendirebilir ve uygun durumlarda yanıt oluşturma süresini azaltabilir.
Son yıllarda Speculative Decoding; Google DeepMind, NVIDIA, Meta, Microsoft ve birçok yapay zekâ araştırma kuruluşunun inference optimizasyon çalışmalarında önemli bir yer edinmiştir.
Speculative Decoding Nedir?
Speculative Decoding, küçük ve hızlı bir yardımcı modelin (Draft Model) olası token dizilerini önceden üretmesi, büyük ana modelin (Target Model) ise bu tahminleri doğrulayıp kabul veya reddetmesiyle çalışan bir çıkarım hızlandırma tekniğidir.
Bu yöntem sayesinde:
- Yanıt süresi kısalabilir.
- GPU kaynakları daha verimli kullanılabilir.
- Büyük modeller daha hızlı yanıt verebilir.
- Uygun senaryolarda inference maliyeti azaltılabilir.
Speculative Decoding Nasıl Çalışır?
Genel süreç şu şekilde ilerler:
1. Kullanıcı İstek Gönderir
Örneğin:
"Python'da hızlı sıralama algoritmasını açıkla."
2. Draft Model Çalışır
Küçük model, sonraki token'lar için bir tahmin dizisi oluşturur.
3. Target Model Tahminleri Doğrular
Büyük model, Draft Model'in oluşturduğu token'ları kendi olasılık dağılımına göre değerlendirir.
4. Uygun Token'lar Kabul Edilir
Target Model tarafından uygun bulunan token'lar kullanılır. Uygun olmayan tahminler reddedilerek üretim ana modelin sonucuna göre devam eder.
5. Süreç Tekrar Eder
Yeni token'lar için yeniden tahmin ve doğrulama yapılır.
Draft Model Nedir?
Draft Model, Target Model'e göre daha küçük ve hızlı çalışan yardımcı modeldir.
Temel görevi, Target Model'in üretmesi muhtemel token'ları önceden tahmin etmektir.
Draft Model'in tahminleri ne kadar başarılı olursa, Speculative Decoding'in sağlayabileceği hız avantajı da o kadar yüksek olabilir.
Target Model Nedir?
Target Model, asıl sonucu belirleyen büyük modeldir.
Görevi:
- Draft Model'in tahminlerini değerlendirmek,
- Uygun token'ları kabul etmek,
- Uygun olmayan token'ları reddetmek,
- Nihai çıktı dağılımını korumaktır.
Speculative Decoding Neden Önemlidir?
Standart autoregressive inference sürecinde model, token'ları sıralı biçimde üretir. Her yeni token için önceki çıktılardan yararlanılarak yeni bir hesaplama adımı gerçekleştirilir.
Speculative Decoding ise küçük modelin birden fazla token'ı önceden tahmin etmesini ve büyük modelin bu tahminleri daha toplu biçimde değerlendirmesini sağlar.
Bu yaklaşım özellikle büyük modellerde token üretiminin darboğazlarını azaltmaya yardımcı olabilir.
Speculative Decoding'in Avantajları
Daha Hızlı Yanıt
Uygun görevlerde token üretim hızını artırabilir.
Daha Düşük Gecikme
Gerçek zamanlı sohbet uygulamalarında kullanıcı deneyimini iyileştirebilir.
GPU Kaynaklarının Daha Verimli Kullanılması
Target Model'in hesaplama kapasitesinden daha etkin yararlanılabilir.
Büyük Modellerin Daha Verimli Sunulması
Yüksek maliyetli modellerin servis edilmesinde performans avantajı sağlayabilir.
Karşılaşılan Zorluklar
Draft Model Kalitesi
Draft Model'in tahminleri zayıfsa kabul oranı düşebilir ve beklenen hız avantajı azalabilir.
Ek Model Gereksinimi
Sistemde Target Model'e ek olarak Draft Model'in de çalıştırılması gerekir.
Doğrulama Maliyeti
Target Model'in tahminleri doğrulaması için ek hesaplama yapılır.
Model Uyumluluğu
Draft ve Target Model'in birlikte verimli çalışması için uygun mimari ve entegrasyon gerekebilir.
Nerelerde Kullanılıyor?
Sohbet Botları
Gerçek zamanlı yanıtların daha hızlı oluşturulmasında.
AI Agent
Birden fazla adım içeren görevlerde inference gecikmesini azaltmak için.
Kod Üreten Modeller
Uzun kod çıktılarının daha hızlı oluşturulmasında.
Bulut Yapay Zekâ
Büyük model servislerinde inference verimliliğini artırmak için.
Kurumsal AI Platformları
Yüksek istek hacmine sahip LLM altyapılarında.
Speculative Decoding ile KV Cache Arasındaki Fark
KV Cache
Önceki token'larla ilgili attention hesaplamalarının bir bölümünü saklayarak tekrar hesaplama ihtiyacını azaltır.
Speculative Decoding
Küçük bir modelin gelecek token'ları önceden tahmin etmesini sağlayarak token üretim sürecini hızlandırmayı amaçlar.
İki teknik aynı inference sisteminde birlikte kullanılabilir.
Speculative Decoding ile MoE Arasındaki Fark
MoE
Model içerisindeki farklı Expert'lerden yalnızca gerekli olanların belirli token'lar için kullanılmasını sağlayan model mimarisidir.
Speculative Decoding
Inference sırasında token üretimini hızlandırmaya yönelik bir optimizasyon tekniğidir.
Dolayısıyla biri model mimarisi, diğeri ise çıkarım optimizasyon yaklaşımıdır.
Gelecekte Speculative Decoding
Büyük dil modellerinin daha hızlı ve düşük maliyetle çalıştırılması önem kazandıkça Speculative Decoding'in de gelişmeye devam etmesi beklenmektedir.
Gelecekte:
- Daha güçlü Draft Model mimarileri geliştirilebilir.
- Çok modlu modellerde yeni speculative decoding yöntemleri kullanılabilir.
- Uzun bağlamlı modeller için yeni optimizasyonlar ortaya çıkabilir.
- Inference Engine'ler speculative decoding'i daha gelişmiş biçimde destekleyebilir.
- Büyük ölçekli yapay zekâ servislerinde önemli optimizasyon yöntemlerinden biri olmaya devam edebilir.
Sık Sorulan Sorular
Speculative Decoding nedir?
Küçük bir Draft Model'in olası token'ları önceden tahmin ettiği, büyük Target Model'in ise bu tahminleri doğruladığı inference hızlandırma tekniğidir.
Speculative Decoding neden önemlidir?
Büyük dil modellerinin uygun senaryolarda daha hızlı yanıt üretmesine yardımcı olabilir ve inference verimliliğini artırabilir.
Sonuçların doğruluğunu düşürür mü?
Doğru uygulandığında amaç, Target Model'in üretim davranışını koruyarak hız kazanmaktır. Draft Model yalnızca tahmin üretir; nihai doğrulama Target Model tarafından gerçekleştirilir.
Gelecekte daha yaygın olacak mı?
Evet. Özellikle büyük ölçekli LLM servisleri, gerçek zamanlı uygulamalar ve yüksek trafik alan inference altyapılarında kullanımının artması beklenmektedir.
Kaynaklar
Google Research – Accelerating Large Language Model Decoding with Speculative Sampling, NVIDIA AI Technical Blog, Hugging Face – Speculative Decoding Guide, IEEE Xplore Digital Library, arXiv – Fast Inference from Transformers via Speculative Decoding, Microsoft Research – LLM Inference Optimization
Editör Notu
Bu içerik Bitcanli Editörü tarafından hazırlanmıştır. İçerikte yer alan bilgiler yalnızca bilgilendirme amacı taşımaktadır. Speculative Decoding ve büyük dil modellerinin çıkarım optimizasyon teknikleri hızla gelişmektedir. Güncel akademik araştırmaların, teknik raporların ve açık kaynak projelerin düzenli olarak takip edilmesi önerilir.






Bunlar da ilginizi çekebilir
-i6a7b8e2f41de7-700x394.png)
Yapay Zekâ Şirketleri Kendi İnternetini Kuruyor: AI Trafiği Neden Bu Kadar Büyüdü?
Yapay zekâ sistemleri büyüdükçe binlerce GPU arasında taşınan veri de artıyor. AI networking teknolojileri, teknoloji şirketlerinin veri merkezi altyapısını yeniden şekillendiriyor.
1 ay önce
Inference Labs Nedir? Doğrulanabilir Yapay Zekâ (Verifiable AI) Altyapısı Nasıl Çalışır?
Yapay zekâ bir sonuç ürettiğinde ona neden güvenelim? Inference Labs, AI çıktılarının gerçekten nasıl üretildiğini kriptografik kanıtlarla doğrulamayı amaçlıyor.
1 ay önce
Atoma Network Nedir? Merkeziyetsiz Yapay Zekâ Çıkarım (AI Inference) Ağı Nasıl Çalışır?
Yapay zekâ çalışırken verileriniz ve modelin kendisi gerçekten güvende mi? Atoma, AI çıkarımını merkeziyetsiz altyapı, doğrulanabilir hesaplama ve gizli işlem teknolojileriyle yeniden ele alıyor.
1 ay önce