
-i6a77249e192b0.png)

Vision Language Model (VLM) Nedir? Yapay Zekâ Görselleri ve Metni Birlikte Nasıl Anlıyor?
Vision Language Model (VLM), yapay zekânın görselleri ve doğal dili birlikte yorumlamasını sağlayan multimodal yaklaşımı ifade eder. Peki VLM'ler fotoğraf, belge ve grafiklerden nasıl anlam çıkarıyor ve klasik Computer Vision sistemlerinden nasıl ayrılıyor?
23/08/2026 15:56 | Son Güncelleme : 16/09/2026 18:55 | Netosfer
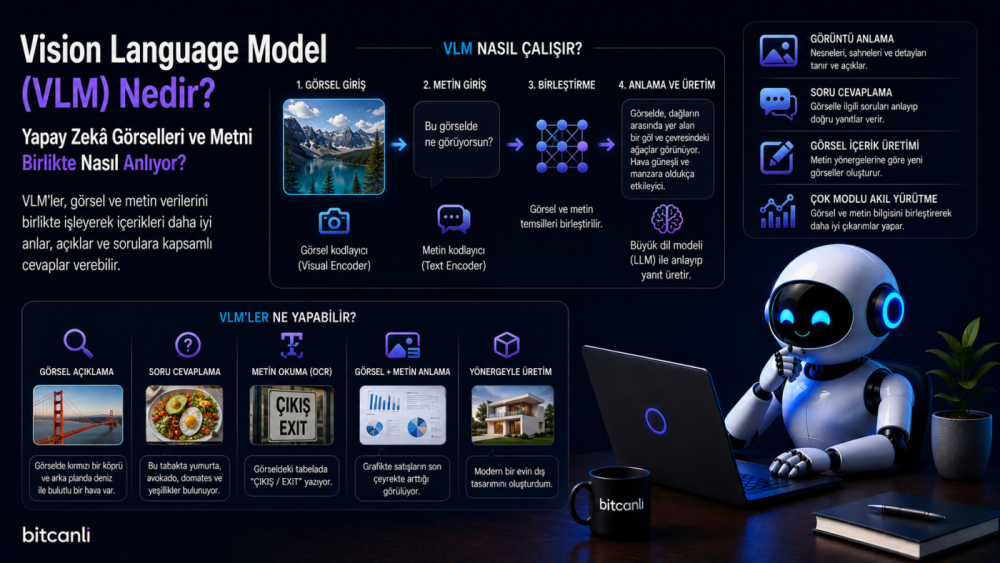
Yapay zekâ modelleri uzun yıllar boyunca yalnızca metin veya yalnızca görsel veriler üzerinde çalışıyordu. Ancak gerçek dünyada insanlar bir fotoğrafa bakarken aynı anda yazıları okuyabilir, nesneleri tanıyabilir ve gördüklerini yorumlayabilir.
Bu yeteneği yapay zekâya kazandırmak amacıyla geliştirilen Vision Language Model (VLM), görsel ve metin verilerini birlikte anlayabilen, yorumlayabilen ve bunlar arasında ilişki kurabilen yapay zekâ modelidir.
Bugün GPT-4o, Gemini, Claude, LLaVA, Qwen-VL ve birçok modern multimodal model, görsel ve dil yeteneklerini bir araya getiren mimariler kullanmaktadır.
Vision Language Model (VLM) Nedir?
Vision Language Model (VLM), görseller ile doğal dili aynı sistem içinde işleyerek görüntüleri anlayabilen ve bunlar hakkında metin üretebilen yapay zekâ modelidir.
Bu sayede model;
- Fotoğrafları analiz edebilir.
- Grafikleri yorumlayabilir.
- Belgeleri okuyabilir.
- Görseller hakkında soruları cevaplayabilir.
- Görsel ve metin arasındaki ilişkileri değerlendirebilir.
VLM'lerin temel özelliği, görsel bilgiyi yalnızca sınıflandırmak yerine bu bilgiyi doğal dil üzerinden yorumlayabilmesidir.
VLM Nasıl Çalışır?
Genel süreç şu şekildedir:
1. Kullanıcı Görsel Gönderir
Sisteme;
- Fotoğraf,
- Grafik,
- Belge,
- Ekran görüntüsü
gibi görsel veriler gönderilebilir.
2. Vision Encoder Çalışır
Görsel, model tarafından işlenebilecek sayısal temsillere dönüştürülür.
3. Görsel ve Metin Bilgileri Birleştirilir
Görselden elde edilen bilgiler, kullanıcının metinsel isteğiyle birlikte değerlendirilir.
4. Model Analiz Yapar
Model görsel içeriği ve kullanıcı sorusunu aynı bağlam içerisinde yorumlar.
5. Çıktı Üretilir
Model analiz sonucunu doğal dilde kullanıcıya aktarır.
Vision Encoder Nedir?
Vision Encoder, görsel verileri analiz ederek bunlardan anlamlı özellikler çıkaran model bileşenidir.
Görevi;
- Nesneleri ve görsel özellikleri algılamak,
- Görsel içerisindeki metinleri işlemek,
- Görüntünün anlamını temsil eden özellikler oluşturmak
gibi işlemleri gerçekleştirmektir.
Bu görsel temsiller daha sonra dil modeli tarafından kullanılabilecek bir forma dönüştürülür.
VLM Neden Önemlidir?
Metin odaklı modeller görsel içeriği doğrudan anlayamazken, yalnızca Computer Vision görevlerine odaklanan sistemler de doğal dil üzerinden kapsamlı etkileşim kurmakta sınırlı kalabilir.
VLM yaklaşımı, görsel algılama ile dil anlama yeteneklerini aynı sistem içerisinde birleştirir.
Böylece kullanıcı bir fotoğraf gönderip doğrudan soru sorabilir, bir grafiğin yorumlanmasını isteyebilir veya bir belgenin içeriğini analiz ettirebilir.
VLM'in Yapısı
VLM mimarileri kullanılan modele göre değişebilse de yaygın olarak üç temel bileşenden söz edilebilir.
Vision Encoder
Görsel veriyi işler ve özelliklerini çıkarır.
Projector
Vision Encoder'dan gelen görsel temsilleri dil modelinin kullanabileceği ortak temsil alanına dönüştürür.
Large Language Model
Görsel ve metinsel bilgileri birlikte değerlendirerek doğal dilde çıktı oluşturur.
Her VLM aynı mimariyi kullanmaz. Bazı modeller daha farklı görsel kodlayıcılar, bağlantı katmanları veya multimodal mimariler kullanabilir.
Nerelerde Kullanılıyor?
Belge Analizi
PDF, taranmış belge, tablo ve ekran görüntülerinin analizinde kullanılabilir.
Sağlık
Tıbbi görüntülerin değerlendirilmesine yardımcı olan araştırma ve karar destek sistemlerinde kullanılabilir.
Eğitim
Diyagram, grafik ve görsellerin açıklanmasında kullanılabilir.
E-Ticaret
Ürün fotoğraflarını analiz etmek ve görsel içerik üzerinden kullanıcı sorgularını yanıtlamak için kullanılabilir.
Robotik
Robotların kamera verilerini anlamasına ve çevreleri hakkında dil tabanlı çıkarımlar yapmasına yardımcı olabilir.
Otonom Sistemler
Kamera ve diğer sensörlerden gelen bilgilerin yorumlanmasında kullanılabilir.
VLM'in Avantajları
Görsel Anlama
Görsellerdeki nesneleri, sahneleri ve ilişkileri yorumlayabilir.
OCR Yeteneği
Uygun mimarilerde görsel içerisindeki metinleri okuyup yorumlayabilir.
Çok Modlu Muhakeme
Görsel ve metinsel bilgileri birlikte değerlendirerek daha kapsamlı yanıtlar oluşturabilir.
Daha Doğal Kullanım
Kullanıcı yalnızca bir görsel göndererek sistemle etkileşime geçebilir.
Karşılaşılan Zorluklar
Yüksek Hesaplama İhtiyacı
Görsel işleme, özellikle yüksek çözünürlüklü görüntülerde ek hesaplama maliyeti oluşturabilir.
Karmaşık Görseller
Yoğun, düşük kaliteli veya belirsiz görseller modelin hata yapma ihtimalini artırabilir.
Görsel Halüsinasyon
Model, görüntüde bulunmayan bir nesneyi veya ayrıntıyı varmış gibi yorumlayabilir.
Eğitim Verisi
Yüksek kaliteli görsel-metin eşleştirmeleri ve multimodal eğitim verileri model performansı açısından önemlidir.
Popüler VLM Modelleri
GPT-4o
Görsel ve metinsel girdileri birlikte işleyebilen multimodal model ailesindendir.
Gemini
Google'ın metin, görsel ve diğer veri türlerini birlikte işleyebilen multimodal model ailesidir.
Claude
Görsel ve belge analizi yeteneklerine sahip multimodal modeller sunar.
LLaVA
Açık kaynak Vision Language Model araştırmalarında öne çıkan projelerden biridir.
Qwen-VL
Alibaba'nın görsel ve dil yeteneklerini birleştiren model ailesidir.
InternVL
Açık kaynak multimodal model ailesi içerisinde yer alan VLM yaklaşımıdır.
VLM ile Multimodal AI Arasındaki Fark
Multimodal AI
Metin, görsel, ses ve video gibi birden fazla veri türünü birlikte işleyebilen daha geniş yapay zekâ yaklaşımıdır.
VLM
Özellikle görsel ve metin arasındaki etkileşime odaklanan model türüdür.
Dolayısıyla VLM, multimodal AI'ın belirli bir alt alanı olarak değerlendirilebilir.
VLM ile Computer Vision Arasındaki Fark
Computer Vision
Bilgisayarların görsel verileri algılamasını ve analiz etmesini sağlayan daha geniş teknoloji alanıdır.
Vision Language Model
Görsel bilgiyi doğal dil yetenekleriyle birleştirerek görüntüler hakkında açıklama, soru-cevap ve daha karmaşık yorumlama görevleri gerçekleştirebilir.
Bu nedenle VLM'ler Computer Vision yeteneklerini dil modeliyle birleştiren mimariler olarak düşünülebilir.
Gelecekte Vision Language Models
VLM teknolojilerinin özellikle multimodal yapay zekâ, robotik ve belge analizi alanlarında gelişmeye devam etmesi beklenmektedir.
Öne çıkan gelişmeler arasında;
- Robotların çevrelerini görsel olarak daha iyi anlaması,
- AI Agent'ların görsel verileri karar süreçlerine dahil etmesi,
- Gerçek zamanlı video analizinin gelişmesi,
- Belge ve grafik analizinin daha otomatik hâle gelmesi,
- Daha küçük ve cihaz üzerinde çalışabilen VLM'lerin geliştirilmesi
yer alıyor.
Sık Sorulan Sorular
Vision Language Model nedir?
Vision Language Model, görsel ve doğal dil verilerini birlikte işleyerek görüntüleri anlayabilen ve bunlar hakkında doğal dilde yanıt üretebilen yapay zekâ modelidir.
VLM neden önemlidir?
Fotoğraf, belge ve grafik gibi görsel içeriklerin doğal dil üzerinden analiz edilmesini ve bu içerikler hakkında soru-cevap yapılmasını mümkün kılar.
Computer Vision ile aynı mı?
Hayır. Computer Vision daha geniş bir görsel işleme alanıdır. VLM ise görsel bilgiyi dil modeliyle birleştirerek doğal dil tabanlı görevler gerçekleştirebilir.
VLM ile Multimodal AI aynı mı?
Hayır. Multimodal AI birden fazla veri türünü kapsayan genel yaklaşımdır. VLM ise özellikle görsel ve dil verilerinin birlikte işlenmesine odaklanır.
Gelecekte daha yaygın olacak mı?
Özellikle multimodal yapay zekâ, robotik, belge analizi ve AI Agent sistemlerinin gelişmesiyle VLM kullanımının artması beklenmektedir.
Kaynaklar
OpenAI – GPT-4o Technical Report, Google DeepMind – Gemini Technical Report, LLaVA Technical Paper, Qwen-VL Technical Report, IEEE Xplore Digital Library, arXiv – Vision-Language Models: A Survey
Editör Notu
Bu içerik Bitcanli Editörü tarafından hazırlanmıştır. İçerikte yer alan bilgiler yalnızca bilgilendirme amacı taşımaktadır. Vision Language Model teknolojileri hızla gelişmekte olup, geleceğin multimodal yapay zekâ sistemlerinde önemli bir rol üstlenmektedir. Güncel akademik araştırmaların, teknik raporların ve açık kaynak projelerin düzenli olarak takip edilmesi önerilir.






Bunlar da ilginizi çekebilir
-i6a7b8e2f41de7-700x394.png)
Yapay Zekâ Şirketleri Kendi İnternetini Kuruyor: AI Trafiği Neden Bu Kadar Büyüdü?
Yapay zekâ sistemleri büyüdükçe binlerce GPU arasında taşınan veri de artıyor. AI networking teknolojileri, teknoloji şirketlerinin veri merkezi altyapısını yeniden şekillendiriyor.
1 ay önce
Inference Labs Nedir? Doğrulanabilir Yapay Zekâ (Verifiable AI) Altyapısı Nasıl Çalışır?
Yapay zekâ bir sonuç ürettiğinde ona neden güvenelim? Inference Labs, AI çıktılarının gerçekten nasıl üretildiğini kriptografik kanıtlarla doğrulamayı amaçlıyor.
1 ay önce
Atoma Network Nedir? Merkeziyetsiz Yapay Zekâ Çıkarım (AI Inference) Ağı Nasıl Çalışır?
Yapay zekâ çalışırken verileriniz ve modelin kendisi gerçekten güvende mi? Atoma, AI çıkarımını merkeziyetsiz altyapı, doğrulanabilir hesaplama ve gizli işlem teknolojileriyle yeniden ele alıyor.
1 ay önce