
-i6a77249e192b0.png)

Multimodal AI Nedir? Yapay Zekâ Metin, Görsel, Ses ve Videoyu Aynı Anda Nasıl Anlıyor?
Multimodal AI, yapay zekânın metin, görsel, ses ve video gibi farklı veri türlerini aynı anda değerlendirerek daha kapsamlı sonuçlar üretmesini sağlıyor. Peki bu sistemler nasıl çalışıyor ve klasik dil modellerinden hangi yönleriyle ayrılıyor?
23/08/2026 15:58 | Son Güncelleme : 16/09/2026 18:55 | Netosfer
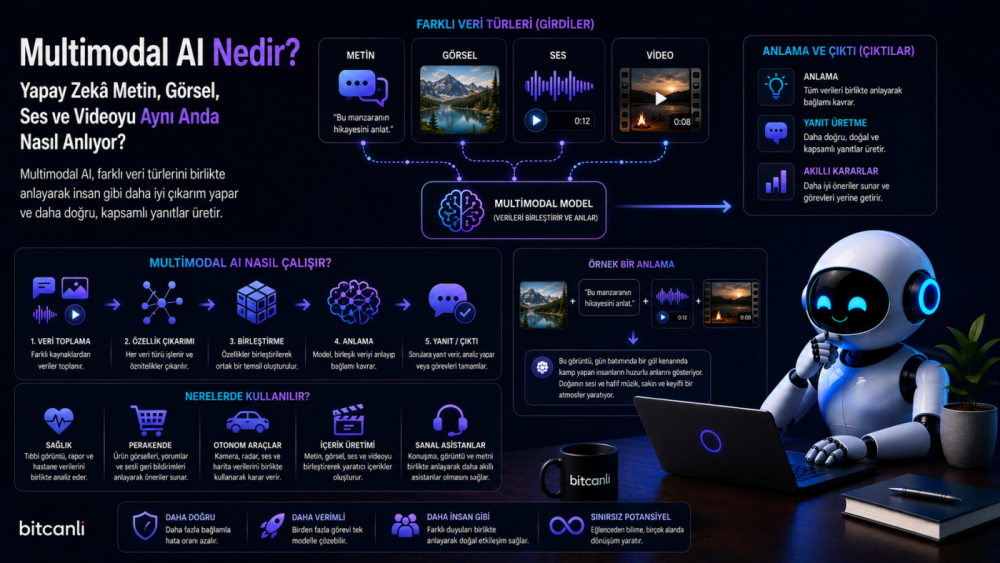
İlk nesil yapay zekâ modelleri genellikle tek bir veri türüne odaklanıyordu. Bir model metinleri işlerken başka bir model görselleri analiz ediyor, ses veya video için ise farklı sistemler kullanılıyordu.
Günümüzde geliştirilen Multimodal AI (Çok Modlu Yapay Zekâ) sistemleri ise metin, görsel, ses ve video gibi farklı veri türlerini aynı sistem içinde işleyebiliyor. Böylece yapay zekâ, gerçek dünyadaki bilgileri daha kapsamlı bir şekilde değerlendirebiliyor.
OpenAI, Google DeepMind, Anthropic, Meta ve Microsoft gibi şirketlerin geliştirdiği yeni nesil yapay zekâ sistemlerinde multimodal yetenekler giderek daha önemli hâle geliyor.
Multimodal AI Nedir?
Multimodal AI, birden fazla veri türünü aynı anda işleyebilen, bu veriler arasındaki ilişkileri değerlendirebilen ve farklı formatlarda çıktı üretebilen yapay zekâ sistemlerinin genel adıdır.
Bu veri türleri arasında;
- Metin
- Görsel
- Ses
- Video
- Kod
- Tablo
bulunabilir.
Örneğin kullanıcı bir fotoğraf, ses kaydı ve yazılı soru gönderdiğinde multimodal bir sistem bu bilgileri birlikte değerlendirerek tek bir yanıt oluşturabilir.
Modality (Veri Türü) Nedir?
Modality, bir yapay zekâ sisteminin işleyebildiği veri türünü ifade eder.
Örneğin;
- Yazı → Text
- Fotoğraf → Image
- Konuşma → Audio
- Film → Video
farklı modality türleridir.
Multimodal sistemlerin temel özelliği, bu veri türlerinden yalnızca birini değil, birden fazlasını aynı görev içerisinde kullanabilmesidir.
Multimodal AI Nasıl Çalışır?
Genel süreç şu şekildedir:
1. Kullanıcı Veri Gönderir
Sisteme;
- Fotoğraf,
- Ses kaydı,
- Video,
- Yazılı soru
gibi farklı veri türleri gönderilebilir.
2. Model Verileri İşler
Her veri türü, ilgili model bileşenleri tarafından uygun sayısal temsillere dönüştürülür.
3. Bilgiler Birleştirilir
Görsel, ses ve metin gibi farklı kaynaklardan elde edilen bilgiler ortak bir bağlam içerisinde değerlendirilir.
4. Muhakeme Yapılır
Model, farklı veri türlerinden gelen bilgiler arasındaki ilişkileri analiz eder ve göreve uygun bir sonuç oluşturmaya çalışır.
5. Çıktı Üretilir
Sonuç;
- Metin,
- Görsel,
- Ses,
- Video
veya bunların bir kombinasyonu olabilir.
Kullanılan modelin mimarisine bağlı olarak desteklenen giriş ve çıkış türleri değişebilir.
Multimodal AI Neden Önemlidir?
Gerçek dünya yalnızca metinden oluşmaz.
İnsanlar;
- Görür,
- Duyar,
- Konuşur,
- Okur,
- Çevresindeki farklı bilgileri birlikte değerlendirir.
Multimodal AI da farklı veri kaynaklarını aynı görev içerisinde kullanarak yapay zekânın gerçek dünyadaki bilgi akışına daha iyi uyum sağlamasına yardımcı olur.
Örneğin bir yapay zekâ sistemi yalnızca bir ürün açıklamasını okumak yerine ürün fotoğrafını da analiz ederek daha kapsamlı bir değerlendirme yapabilir.
Multimodal AI'ın Temel Bileşenleri
Multimodal sistemlerin mimarisi modele göre değişebilir. Ancak yaygın olarak şu bileşenlerden söz edilebilir:
Vision Encoder
Görselleri işler ve görsel özellikleri çıkarır.
Audio Encoder
Ses verilerini analiz ederek modelin kullanabileceği temsillere dönüştürür.
Language Model
Metni işler, bağlamı değerlendirir ve doğal dilde çıktı oluşturur.
Fusion Layer
Farklı veri türlerinden gelen bilgileri ortak bir temsil veya bağlam içerisinde birleştirebilir.
Decoder
Modelin görevine bağlı olarak nihai çıktıyı oluşturur.
Her multimodal model bu bileşenlerin tamamını aynı şekilde kullanmaz. Modern mimarilerde farklı tasarımlar ve entegrasyon yöntemleri bulunabilir.
Nerelerde Kullanılıyor?
AI Asistanları
Kullanıcıların fotoğraf, metin veya ses üzerinden soru sormasına ve bu veriler hakkında yanıt almasına olanak sağlayabilir.
Sağlık
Tıbbi görüntüler ile doktor notları veya diğer klinik verilerin birlikte değerlendirilmesine yardımcı olabilir.
Otonom Araçlar
Kamera, radar ve diğer sensörlerden gelen bilgilerin birlikte analiz edilmesinde kullanılabilir.
Eğitim
Görselleri açıklama, ders içeriklerini analiz etme ve videoları özetleme gibi görevlerde kullanılabilir.
E-Ticaret
Ürün fotoğraflarını ve ürün açıklamalarını birlikte analiz ederek arama ve öneri sistemlerini geliştirebilir.
Robotik
Robotların görsel ve işitsel çevre verilerini birlikte değerlendirerek karar vermesine yardımcı olabilir.
Multimodal AI'ın Avantajları
Daha Doğal Etkileşim
Kullanıcılar yapay zekâ ile yalnızca yazı üzerinden değil, görsel, ses ve video gibi farklı kanallardan iletişim kurabilir.
Daha Güçlü Muhakeme
Farklı veri kaynaklarının birlikte değerlendirilmesi, bazı görevlerde daha kapsamlı analiz yapılmasını sağlayabilir.
Daha Zengin Çıktılar
Sistem yalnızca metin üretmekle sınırlı kalmayabilir; kullanılan mimariye göre görsel, ses veya diğer formatlarda çıktı da oluşturabilir.
Daha Geniş Kullanım Alanı
Tek bir veri türüne bağlı olmayan sistemler sağlık, eğitim, robotik, otomotiv ve e-ticaret gibi birçok sektörde kullanılabilir.
Karşılaşılan Zorluklar
Büyük Hesaplama Gücü
Birden fazla veri türünü aynı anda işlemek, yalnızca metin işleyen sistemlere göre daha yüksek hesaplama kaynakları gerektirebilir.
Veri Uyumu
Farklı veri türlerinden gelen bilgilerin aynı bağlam içerisinde doğru şekilde ilişkilendirilmesi teknik açıdan zordur.
Eğitim Maliyeti
Multimodal modellerin eğitimi için büyük ve kaliteli veri kümelerine ihtiyaç duyulabilir.
Güvenlik
Metin, görsel, ses ve video gibi farklı giriş türleri yeni saldırı yüzeyleri ve güvenlik riskleri oluşturabilir.
Multimodal AI ile LLM Arasındaki Fark
LLM (Large Language Model)
LLM'ler temel olarak doğal dil işleme ve metin üretimi üzerine geliştirilmiştir. Modern LLM'lerin bazıları görsel veya diğer veri türlerini de destekleyebilir ancak kavramsal olarak LLM, dil modeli kategorisini ifade eder.
Multimodal AI
Multimodal AI daha geniş bir kavramdır ve metnin yanında görsel, ses ve video gibi farklı veri türlerinin birlikte işlenmesini kapsar.
Bu nedenle her multimodal sistem yalnızca klasik bir metin modeli olarak değerlendirilemez.
Multimodal AI ile Vision Language Model (VLM) Arasındaki Fark
Multimodal AI
Birden fazla veri türünün birlikte işlenmesini kapsayan genel yaklaşımdır.
Vision Language Model (VLM)
Özellikle görsel + metin verilerini birlikte işleyen multimodal model türüdür.
Bu nedenle VLM, Multimodal AI ekosisteminin belirli bir bölümünü oluşturur. Multimodal AI ise ses, video ve diğer veri türlerini de kapsayabilir.
Gelecekte Multimodal AI
Multimodal yapay zekâ sistemlerinin gelişmeye devam etmesiyle birlikte farklı veri türlerini aynı anda işleyebilen modellerin daha yaygın hâle gelmesi beklenmektedir.
Öne çıkan gelişmeler arasında;
- Metin, görsel, ses ve videoyu birlikte işleyen sistemlerin gelişmesi,
- AI Agent'ların çevresel bilgileri daha kapsamlı değerlendirmesi,
- Robotlarda multimodal algılama yeteneklerinin artması,
- Gerçek zamanlı video ve ses analizinin gelişmesi,
- Sağlık, eğitim ve endüstriyel uygulamalarda kullanım alanlarının genişlemesi
yer alıyor.
Sık Sorulan Sorular
Multimodal AI nedir?
Metin, görsel, ses ve video gibi birden fazla veri türünü birlikte işleyebilen yapay zekâ sistemlerinin genel adıdır.
Multimodal AI neden önemlidir?
Farklı veri kaynaklarını aynı görev içerisinde değerlendirerek daha kapsamlı analiz ve daha doğal kullanıcı etkileşimi sağlayabilir.
LLM ile aynı mı?
Hayır. LLM dil modeli kategorisini ifade ederken Multimodal AI, birden fazla veri türünün birlikte işlenmesini kapsayan daha geniş bir yaklaşımdır.
Multimodal AI ile VLM aynı mı?
Hayır. VLM özellikle görsel ve metin verilerinin birlikte işlenmesine odaklanırken Multimodal AI ses, video ve diğer veri türlerini de kapsayabilir.
Gelecekte daha yaygın olacak mı?
Özellikle AI Agent, robotik, sağlık, eğitim ve gerçek zamanlı yapay zekâ uygulamalarında multimodal sistemlerin kullanımının artması beklenmektedir.
Kaynaklar
Google Cloud – Multimodal AI Documentation, Stanford HAI – What is Multimodal AI?, IBM – Multimodal AI, IEEE Xplore Digital Library, arXiv – Multimodal Machine Learning: A Survey and Taxonomy, arXiv – LLMs Meet Multimodal Generation and Editing
Editör Notu
Bu içerik Bitcanli Editörü tarafından hazırlanmıştır. İçerikte yer alan bilgiler yalnızca bilgilendirme amacı taşımaktadır. Multimodal AI teknolojileri hızla gelişmekte olup, farklı veri türlerinin birlikte işlenmesini sağlayan yapay zekâ sistemlerinin yaygınlaşmasında önemli rol oynamaktadır. Güncel akademik araştırmaların, teknik raporların ve açık kaynak projelerin düzenli olarak takip edilmesi önerilir.






Bunlar da ilginizi çekebilir
-i6a7b8e2f41de7-700x394.png)
Yapay Zekâ Şirketleri Kendi İnternetini Kuruyor: AI Trafiği Neden Bu Kadar Büyüdü?
Yapay zekâ sistemleri büyüdükçe binlerce GPU arasında taşınan veri de artıyor. AI networking teknolojileri, teknoloji şirketlerinin veri merkezi altyapısını yeniden şekillendiriyor.
1 ay önce
Inference Labs Nedir? Doğrulanabilir Yapay Zekâ (Verifiable AI) Altyapısı Nasıl Çalışır?
Yapay zekâ bir sonuç ürettiğinde ona neden güvenelim? Inference Labs, AI çıktılarının gerçekten nasıl üretildiğini kriptografik kanıtlarla doğrulamayı amaçlıyor.
1 ay önce
Atoma Network Nedir? Merkeziyetsiz Yapay Zekâ Çıkarım (AI Inference) Ağı Nasıl Çalışır?
Yapay zekâ çalışırken verileriniz ve modelin kendisi gerçekten güvende mi? Atoma, AI çıkarımını merkeziyetsiz altyapı, doğrulanabilir hesaplama ve gizli işlem teknolojileriyle yeniden ele alıyor.
1 ay önce