-i6a77249e192b0.png)

En güncel haberleri, analizleri ve rehberleri tek bir yerde arayın.

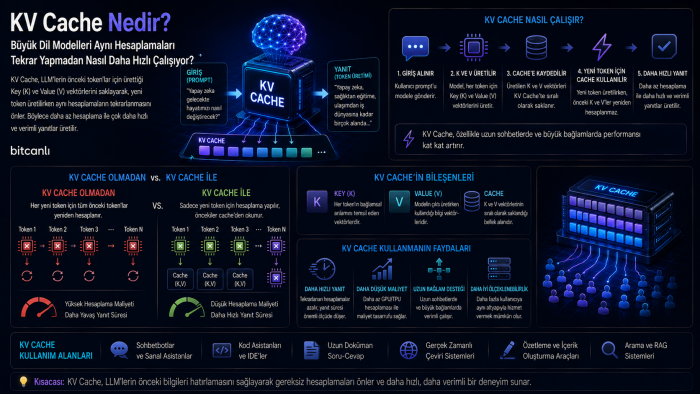
KV Cache, büyük dil modellerinin önceki attention hesaplamalarını yeniden kullanarak inference sürecini daha hızlı ve verimli hâle getirmesini sağlayan temel optimizasyon tekniklerinden biridir.
3 hafta önce