-i6a77249e192b0.png)

En güncel haberleri, analizleri ve rehberleri tek bir yerde arayın.

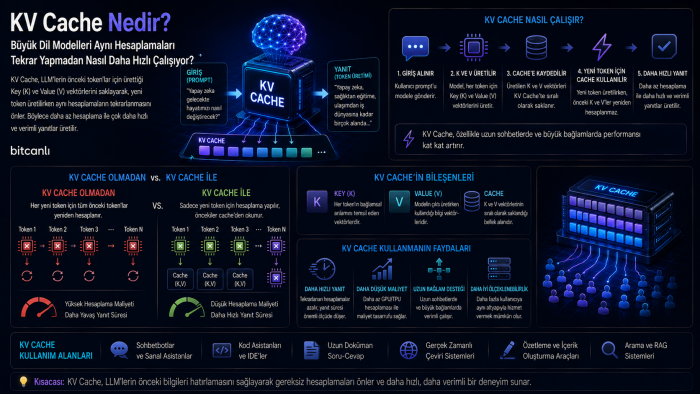
KV Cache, büyük dil modellerinin önceki attention hesaplamalarını yeniden kullanarak inference sürecini daha hızlı ve verimli hâle getirmesini sağlayan temel optimizasyon tekniklerinden biridir.
3 hafta önce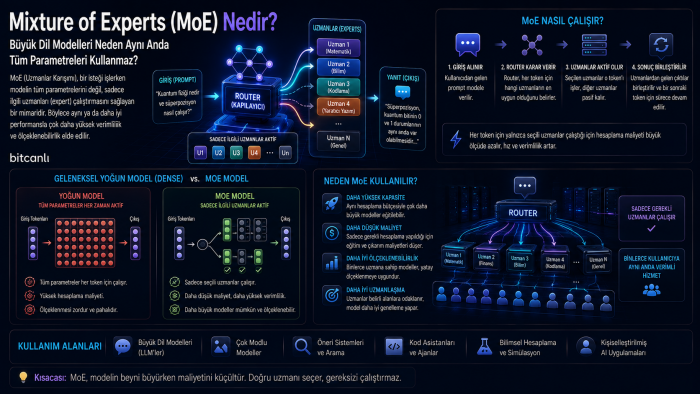
Mixture of Experts (MoE), büyük yapay zekâ modellerinde yalnızca gerekli Expert'leri etkinleştirerek model kapasitesini artırmayı ve hesaplama maliyetini daha verimli yönetmeyi amaçlayan mimaridir.
3 hafta önce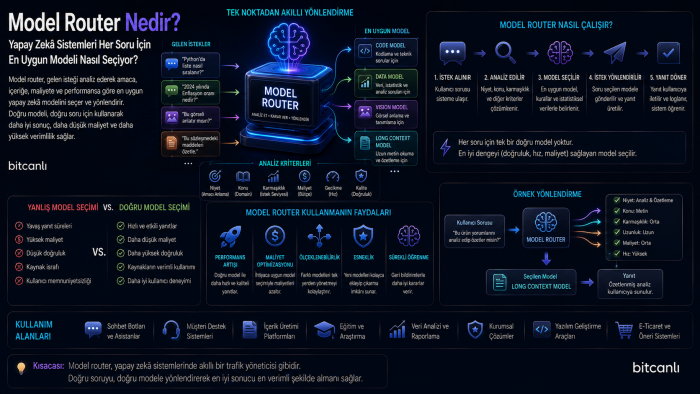
Model Router, yapay zekâ sistemlerinin her kullanıcı isteğini görev, maliyet, hız ve performans gibi kriterlere göre en uygun modele yönlendirmesini sağlayan akıllı karar mekanizmasıdır.
3 hafta önce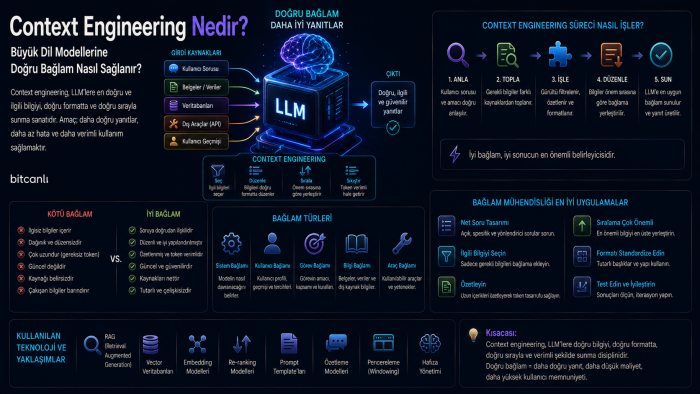
Context Engineering, yapay zekâ modellerine yalnızca iyi bir prompt vermek yerine doğru bilgiyi doğru zamanda seçip sunarak LLM ve AI Agent performansını artırmayı amaçlayan kapsamlı bir yaklaşımdır.
3 hafta önce